美国当地时间10月13日,谷歌Gemini 4 Argon开始面向全球开发者和企业开放。
87%,这是Gemini 4 Argon在ERQA(具身推理基准)上跑出的数字,成绩超过Opus 5.5、Gpt-6 Astra和Fable 5.1。
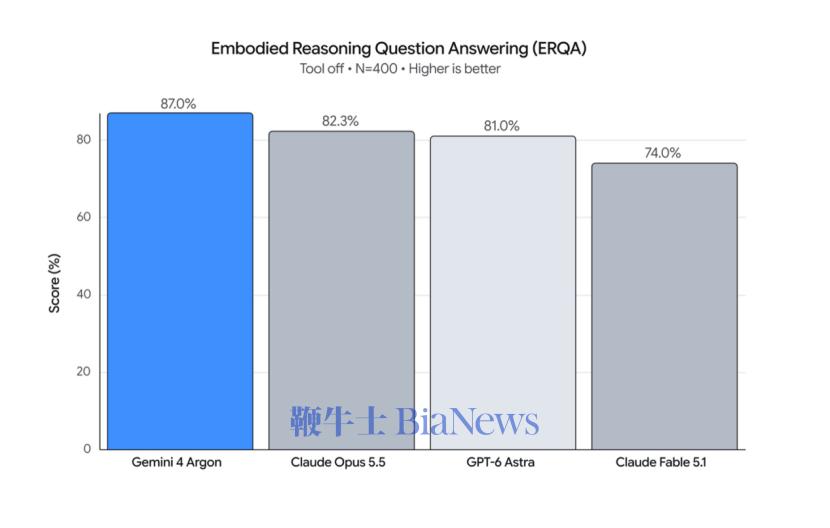
这个数字背后,值得关注的是它拿到该分数时的约束条件:不挂外部工具、不接专用机器人模块、不做具身任务的额外微调,纯推理。DeepMind给其定位措辞是,通用物理推理模型。把“物理”两个字摆上台面。
要理解“纯推理”三个字为什么少见,得先看过去两年的机器人演示是怎么搭出来的。大概架构是,感知一个模型,位姿估计一个模块,抓取规划再一个,最后运动控制收尾。每个环节单拎出来跑基准都不难看,拼在一起,误差开始互相叠加。
再来说ERQA,它主要考的是空间与接触理解。400道多选题,围绕3D环境的空间布局和状态估计展开,覆盖轨迹推理、动作推理、状态估计、空间推理、多视角推理等类别。这和让真实机械爪完成物理抓取是两码事。
Argon在桌面试套里的表现提供了另一个数据点。谷歌的演示中,Argon从一张桌面照片出发构建物理仿真,生成了超过4500条机器人操作训练数据。用这些仿真数据微调“视觉-语言-动作”模型后,真实机器人的任务成功率从56%提升到75%,平均完成时间从35秒降到24秒。
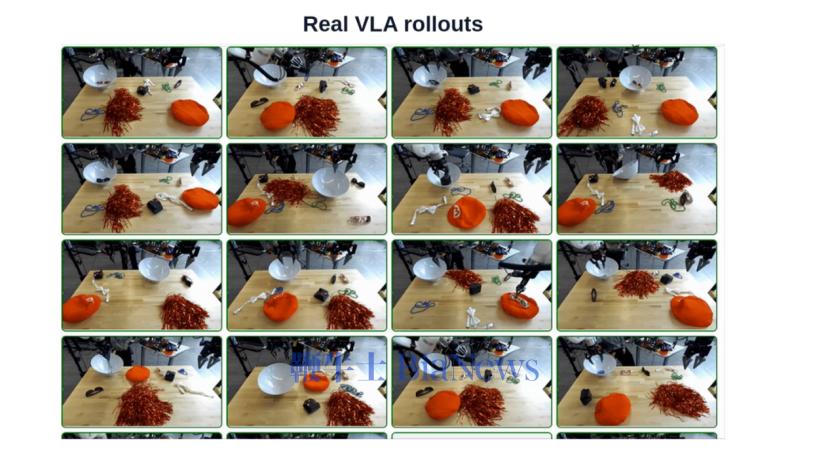
这个数据的含义在于它改变的是数据生产函数。真机数据采集又慢又贵,一个团队一天攒下来的抓取轨迹可能只有几十条。从一张照片生成4500条带物理约束的训练episode,意味着大模型在机器人栈里的角色从“大脑”延伸到了“数据工厂”。
投沙包的演示也值得一提。Argon观看人类投掷的视频,重建环境的空间坐标,计算全身关节运动,自主编写仿真代码,然后迁移到Apptronik的Apollo人形机器人上,后者在真实场地连续投中了7次。
当然以上我们所说的全部来自谷歌内部实验,没有独立第三方复现,任务限于取物投掷类操作,并不等于通用机器人能力。
再来看看其他模型表现如何,OpenAI的GPT-6 Astra在需要文本推导的物理任务上极强。可一旦任务转向直觉视觉物理推理,短板暴露:Scale AI与Elorian发布的HSS基准,522道考察直觉视觉推理的题目,人类基线93.1%,GPT-6 Astra仅得53.6%,且是在最大推理强度下。前沿多模态模型离人类直觉的距离,近40个百分点。
Claude Opus 5.5在ERQA上以82.3%位居Argon之后。但在研究级物理基准CritPt上,它与GPT-6 Astra并列31.7%。CritPt考的是研究级物理问题,这一占比意味着前沿模型在解决真实物理研究问题上,仍然只做到不到三分之一的正确率。
更广的版图上看,PhyX基准包含3000道物理推理题,覆盖热力学、电磁学、力学、现代物理、光学、波与声学六个核心领域。GPT-4o、Claude 3.7 Sonnet和GPT-o4-mini的准确率分别为32.5%、42.2%和45.8%,与人类专家的性能差距超过29%。
论文的结论更是十分直接,当前模型过度依赖记忆的学科知识、过度依赖数学公式、过度依赖肤浅的视觉模式匹配,而非真正的物理理解。
这些数据放在一起,可以看出物理推理不是一组能力的集合。文本推演、视觉常识、空间关系、材质形变:每个模型在不同维度上表现差异极大,单一基准分数往往掩盖了这种分裂。
最近网上流传的一个非正式对比测试,恰好能说明这道墙在哪里。
同样的提示词要求生成一袋“小熊软糖”,Claude Opus 5.5和Gemini 4 Argon交出了完全不同的结果。测试者对两者做了完全相同的操作:拉一只爪子、拉扯头部、压扁、扔出去、把整袋倒在上面。
Opus 5.5生成的熊是真正的果冻。拉动一只爪子,它伸展成一条薄薄的橡胶股,然后向后断裂并晃动。压扁一个,它像煎饼一样摊开,然后又弹回来。扔出去,它从地板上弹起,把旁边的熊推开。外观也是对的:半透明、有光泽、光线直接穿过。
Argon 4生成的熊是实心塑料。手臂变成了一根棍子,熊直飞出去穿过邻居,末端的堆只是叠在自己身上。外观不透光,没有任何软体形变。
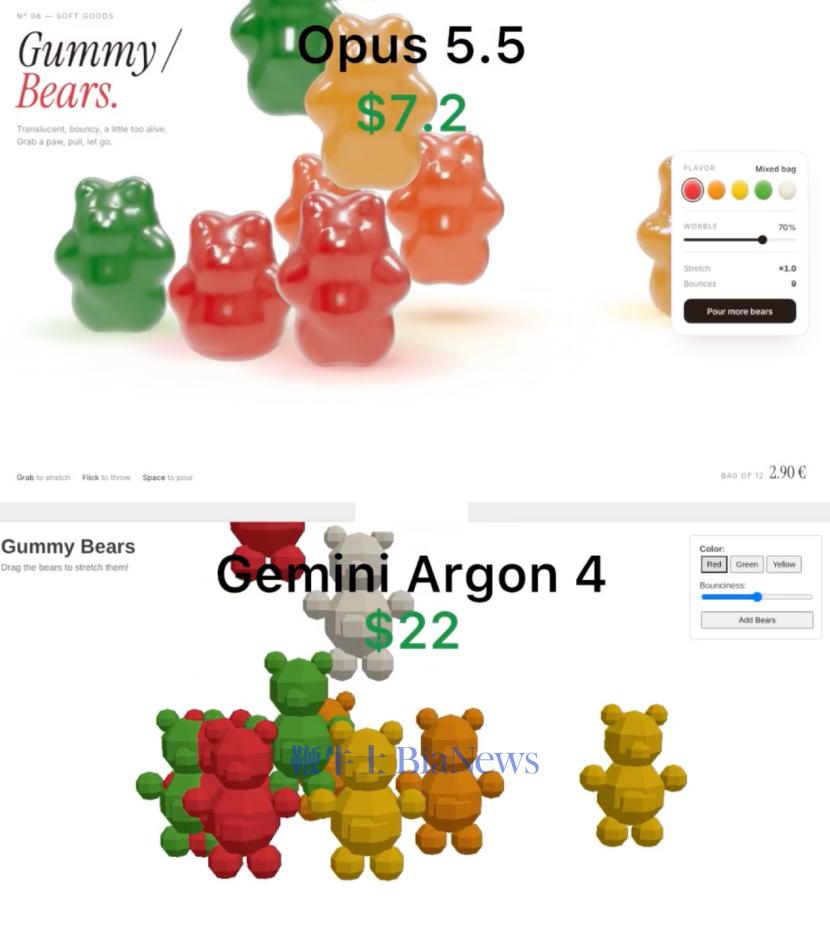
前者花了7.2美元,后者花了22美元。贵的那个,并没有带来更真实的物理直觉。
回到“通用物理推理”这一定位。Gemini 4Argon的87%在选择题里,选出正确的旋转角度或抓取位置,与让真实机械爪克服摩擦和材质形变完成抓取,是两码事。官方演示里的“零样本控制”也有严密的工程脚手架:腕部相机输入被打上2cm世界坐标网格,多次调用预先写好的高级动作API,Spot的演示还需要足部校验器和手部校验器组成的多智能体群反复核对,再验证平衡性。
所以,当我们把所有数据放在一起看,真实的图景是这样的:Gemini 4Argon在具身力学的纯推理上,确实第一次把单模型前向推理做到了超越所有前沿模型的位置。这个突破的工程意义在于栈的简化,接口干净了,调试成本就能降下来。同时它把仿真数据生成变成了一条可量化的生产线,对机器人迭代速度的影响可能比基准分数更大。
但它没有解决的,是物理推理作为一组能力的完整性问题。热力学、电磁学、光学……这些维度的推理能力目前没有数据。Argon是否做得更好,谷歌没说。
还有一道更深的墙,通用物理推理要求从视觉和交互中长出物理直觉。物理世界的形状、材质、质量分布、接触面摩擦、施力角度,每加一个变量,组合空间就翻一倍。
通用物理推理要解的,本质上是怎么用一套参数去覆盖这个爆炸量级组合空间。Gemini 4Argon在力学维度上迈了一步,只是那道真正的墙一直还在。
(转载自第四波)
 扫码下载app 最新资讯实时掌握