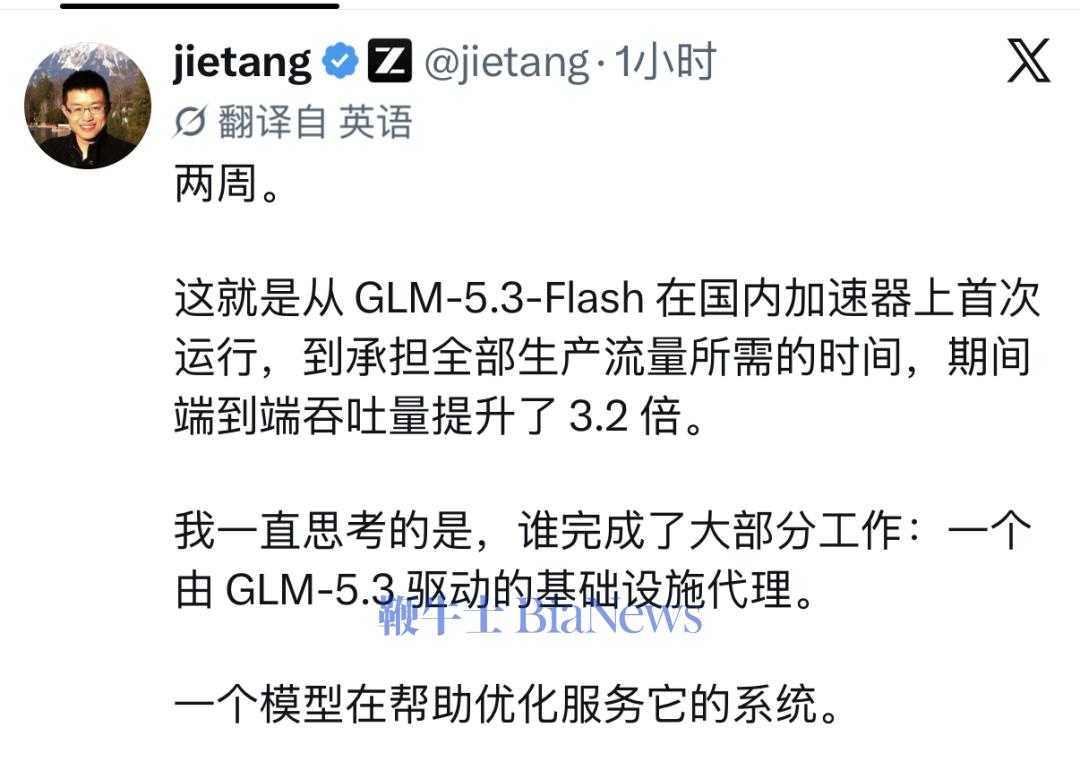
只用了两周时间,GLM-5.3-Flash优化了服务于自身的推理基础设施,端到端吞吐相比初始基线直接提高了3倍。“我们仍远未到达递推自我改进,但最小的循环已经存在”,他说。这相当于用模型优化系统,反过来系统又服务于模型。这就是一种递推自我改进的形式。不过,唐杰表示人类仍然定义目标、构建反馈环境,并审查每项高风险变更。但工程师的角色正在改变,从解决问题的人,变成设计反馈的人。他还透露,整套生产级推理服务建在超过十万张国产加速器的集群上。这也是难点所在。唐杰表示首次在国产加速器集群上完成生产级推理服务的部署,存在很多难点。他提到内存紧,互联带宽也紧,还要扛一百万 token 上下文和多模态请求。而且软件栈不成熟,内核缺失,文档常常只能靠猜。每一次优化都是权衡:用算力换内存,用通信换内存,用精度换容量等。Agent 卡住的时候,很少是因为写不出代码。是因为常常不知道事情为什么变差了。“吞吐掉了 20%”只告诉你坏了。它不告诉你坏在哪一层,当前假设错在哪,下一步该测什么。用强化学习的话说,这是稀疏奖励。端到端基准一跑就是几小时,探索会慢到让人痛苦。为了解决这些问题,唐杰和团队把这套东西显式化了,并称为密集反馈。Agent 可以直接调用。密集反馈要求每个信号都必须是局部的、低成本的,并且客观可验证的。官方技术博客解释称密集不等于把日志和指标一股脑塞给模型。它强调三件事。反馈尽量贴到具体参数、改动、内核、输入条件、线程或代码路径。反馈要便宜、及时,提出假设后马上能验证。反馈要能客观核对,不能只靠感觉。首先,KDA 的上下文并行路径中精度漂移,随着序列长度增长而加剧。原因是 TF32 舍入误差在链式状态-矩阵合并中累积。现在的修复已上游合并到 Flash Linear Attention(PR #1180)。其次,KV 传输从未与 DeepEP 调度重叠。代理追踪了跨越 Python/C++ 边界的调用链,发现节点内路径从未释放 GIL。修复后,传输开销从超过 30% 降到不到 1%。第三,一个解码内核因为分块方式而四次重新计算相同的归一化。代理重构了它,获得了 1.71 倍加速。这个想法来自它通过阅读 SGLang、FLA 和 DeepGEMM 中的现有内核而提炼的“优化骨架”。就在上周,智谱刚融资335亿元。其中明确了6成资金指向同一个目标,递归式自我改进。智谱在公告中指出,下一代GLM模型将在上一代GLM所搭建的环境里训练,形成递归式自我改进(Recursive Self-Improvement)闭环,涵盖数据自产、环境自造、基础设施自我优化三个维度。数据自产,不再完全依赖人类标注。通过模型间自我对弈、规则校验、执行验证、模型评审和人工抽检等方式,自动生成、筛选和积累高质量训练数据,持续回流到预训练、中训练和后训练各阶段。环境自造,让智能体去采集和转化真实世界的任务。智能体自己试做、自己生成验证器、自己检查任务是否可解,不断扩充训练环境的数量、类型和复杂度。要让任务环境成为“可规模化生产及复用的训练资源”。利用模型在编码和系统工程方面的能力,协助开发和优化训练及推理系统的算子、内核、调度、缓存和服务栈,使模型能够逐步参与支撑其自身迭代的基础设施升级。
 扫码下载app 最新资讯实时掌握
 微信好友
 朋友圈
 鞭牛士公众号
 鞭牛士微博