10月28日,斯坦福 HAI团队在胡佛研究所 Traitel 大楼举办了「Confronting Our AI Future」闭幕仪式。
这场活动上,一个非常有名且低调的AI计算机学者、谷歌的技术核心与灵魂人物之一、前Google DeepMind 首席科学家、Discovery Loop创始人Jeff Dean,大家亲切称他为“姐夫”。
Jeff Dean 在 1999 年加入谷歌,成为早期第 20 号员工。这个时间点距离拉里・佩奇、谢尔盖・布林创建谷歌(1998 年 9 月)刚刚一年,可以说 Jeff Dean 是谷歌元老级别的人物。
2011年,Jeff Dean参与创立了 Google Brain 团队,专注于智能机器领域的进展。自那时起,他的工作重心转到了 AI 和 ML 领域的研究、系统和应用,并引领了更广泛 AI/ML 和计算机科学研究社区的发展方向。
2020 年 12 月,Jeff Dean 获得了 2021 年度 IEEE 冯诺依曼奖,以表彰他对大规模分布式计算机系统和人工智能系统科学与工程的贡献。
2023 年 4 月,谷歌宣布将旗下 Google Brain 和 DeepMind 合并,成立了 Google DeepMind。Jeff Dean 担任该部门的首席科学家。
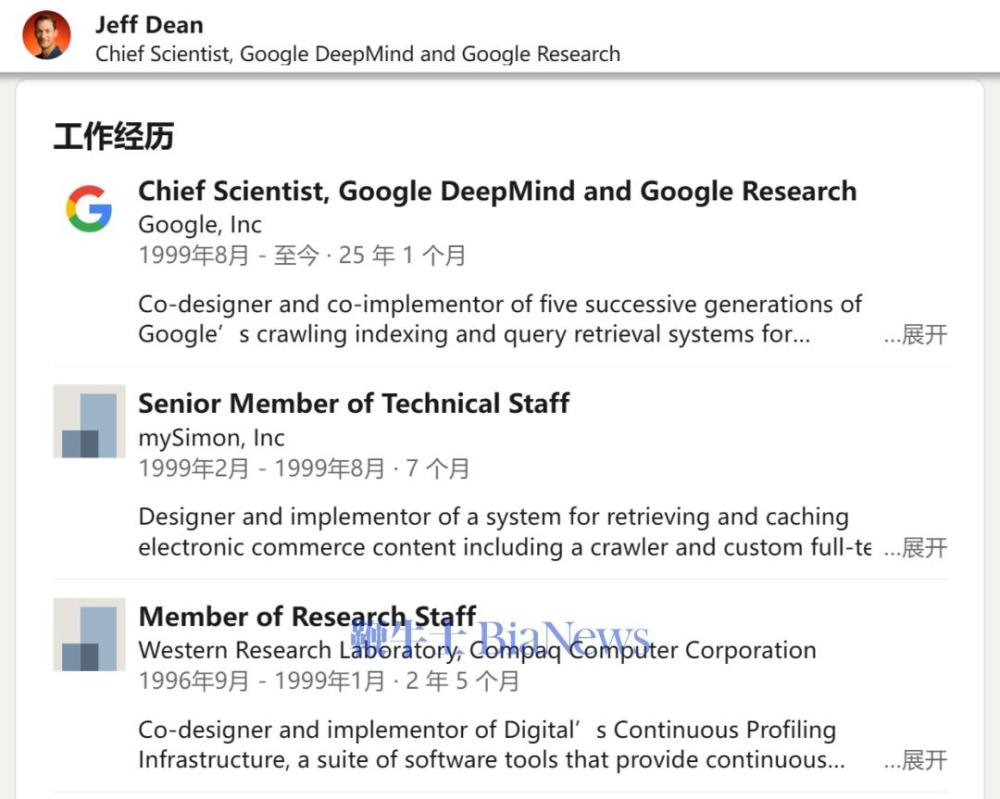
过去27年,Jeff Dean 在谷歌推动了AI搜索技术架构的创立,参与构建 MapReduce、BigTable 等系统,主导创建 TensorFlow,担任 Google 首席科学家,并任 Gemini 项目联合技术负责人,推进了Gemini等生成式AI技术的建立。
2026年8月,Jeff Dean 与长期合作伙伴 Sanjay Ghemawat、Quoc Le、Oriol Vinyals 共同创立了一家名为 Discovery Loop 的非营利/前沿初创公司,专注于用 AI 自动化机器学习、科学与工程研究(AI4S)。
Jeff Dean在演讲中说,只有好的基础模型,不足以解决我们想解决的问题。我们从好的基础模型出发,然后需要Agent智能体+模型,才能真正有效地用工具完成真正复杂的任务。
“我们希望智能体和模型特别擅长创造。拿出惊人的科学或工程突破,很多时候不是做已经做过的事,而是把很多洞察拼在一起,想出真正新的东西,再看它效果如何。我们还认为,智能体和模型应该从之前的实验和经验里学习,既包括解决当前问题过程中的经验,也包括长期积累的经验。有些系统也许已经解过 5000 个问题,那么在解第 5001 个问题时,它们能从跟这个新问题最相关的那批问题里学习。”
Jeff Dean谈到Discovery Loop的目标,是让领域专家的生产力提升 20 倍到 50 倍。
“我们不想把人从这件事里拿掉,我们只是想让那些想解决特定问题的人、让领域专家真正被AI赋能,用更少的力气解决这些问题。”
在对话中,Jeff Dean也对RSI递归式自我改进表达了不同意见,他认为一个通过自我改进的系统能自动开发出垂直模型,然后能看到被尝试的不同方法各自的准确率,希望随着系统跑实验而上升,这才是RSI,而很多外界的RSI存在炒作和泡沫风险。
换句话说,Jeff Dean不否定 RSI 的可能性,但否定 RSI 可以无限加速,存在计算、硬件的物理硬约束,
“所以我们认为,机器学习 15 年的突破带来了能力很强的模型,为自动化机器学习的科学与工程、从而大幅加速发现,铺好了舞台。”Jeff Dean称。
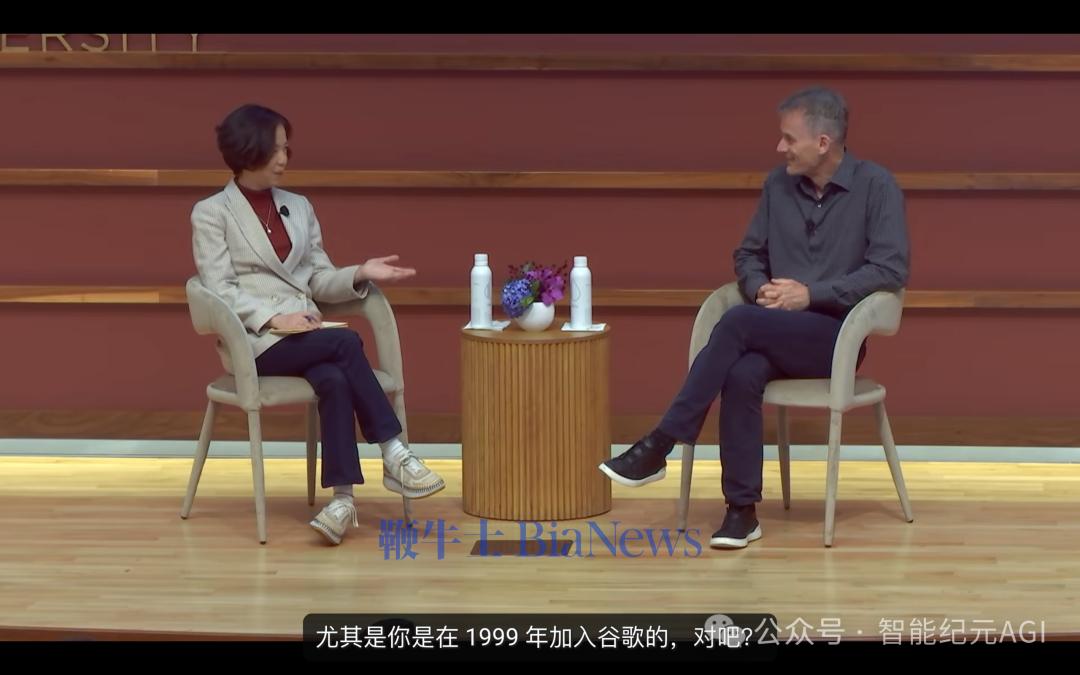
以下是李飞飞与Jeff Dean对话全文:
李飞飞:讲得真好。谢谢你,Jeff。
我想这是最后一场了,对吧,所以我们正好夹在观众和茶歇之间。所以我希望这一场我们能稍微更极客一点,聊一点技术。但我们本来就说好是一场共同讨论,所以我要一人分饰两角,一边问你问题,一边参与讨论。谢谢你刚才的演讲,因为我第一个问题本来就恭喜你做 Discovery Loop。
杰夫·迪恩:谢谢。
李飞飞:你们四个人基本上都算是 Google 的老员工了,尤其是你 1999 年就加入 Google,对吧?过去几年我们看到的宏观技术进展非常清楚。但我还是好奇,过去有没有那么一个时刻,我猜是一两年之内,技术进入了一个状态,让你、Quoc、Sanjay 和 Oriol 觉得,我们必须做点不一样的事,而且这件事不能在 Google 做。
杰夫·迪恩:对,我想我们一直都很兴奋地看到,自动化系统真的能以更自动的方式帮人开发软件系统。
Quoc 十年前就在做神经架构搜索,你可以把它看成那种递归的、自我改进的系统的一个很早的版本:你跟它说,请帮我找出适合计算机视觉问题、或者语言问题的好模型架构。所以我们知道那种方法管用。但在那个时候,你指定搜索空间的方式是一堆很丑的 Python 代码,不像今天可以用自然语言。
今天你可以对一个能力很强的模型加智能体系统说,请去探索可能有助于解读 MRI 图像的模型架构,然后它就会去做。我认为,这深刻改变了我们对计算机系统和 AI 系统能做什么的想象。而且如果你能让这些东西可靠地工作,它会解锁很多东西。尤其对科学和工程来说,那是一组非常成熟的领域,可以真正推进对世界的正面影响。
李飞飞:我明白了。所以真正打动你们的是这个循环,是自我改进,让你们觉得想做这件事。太好了。甚至对我自己来说,我们创办 World Labs 的时候,也是看到了技术到了一个时刻。这跟你们看到的不一样:当我们看到计算机视觉和生成模型汇合,到了能创造出超越文字的生成模型的那一刻,那就是我们创办 World Labs 的时刻。
杰夫·迪恩:有人可能会说我们有点「循环」过头了,但确实是。我还想说,从很小的项目起步这件事,对我们很重要,很多次都是这样,而且真的很有意思。我是说,你们做出来的那些生成模型,现在能做到的事情,真的很了不起。
李飞飞:那我们来聊聊自我改进和递归自我改进(RSI)。我们来学一学,稍微展开一点。
我们在机器学习这个领域的教育背景算是同一代人。我刚才就在心里想,这个概念在它的一生里换过多少个名字。
我做研究生的时候,我们叫增量学习,然后是持续学习,然后是元学习,然后是终身学习和架构搜索,这个你刚提到过。现在我们有自我改进,然后是 RSI。
所以你能不能给观众,尤其是技术背景的观众,一个更严谨的定义,说清什么是自我改进,什么是递归自我改进?我在这里的目的,其实是想把虚构和事实分开。
杰夫·迪恩:当然。如果你想想我刚才说的那些循环Loop,那些循环可以应用到很多种问题上。我把自我改进系统想成这样:你给系统一个目标,让它去改进某个通常可度量的指标,比如一个机器学习模型的准确率,然后它在尝试不同种类的模型架构来提升那个准确率。
李飞飞:停一下。很多机器学习算法都能做到这一点。
杰夫·迪恩:是的。这本身不是递归的。
一个自我改进系统可能是这样:我们把系统指向一堆 MRI 数据和 MRI 结果,然后说,我想开发一个帮助解读 MRI 图像的模型。对吧。那会是一个自我改进系统,你能自动开发出那个模型,然后能看到被尝试的不同方法各自的准确率,希望随着系统跑实验而上升。
李飞飞:但那并没有改进基座系统本身,也就是决定下一步该试什么的那一层,对吧?所以递归自我改进是,你怎么让这种自我改进的做法,反过来改好那个你指望它提出改进的基座系统。如果这么说能讲通的话。
杰夫·迪恩:对,是讲得通的。
李飞飞:对我来说是讲得通的,但我觉得这对很多人来说是个很混乱的概念。而且现在,尤其我们在硅谷,很多人用这个词用得非常随意。作为一个科学家,这其实让我很不安。
所以我想站在这个台上,确保我们把 RSI 定义清楚。那我们来聊聊 RSI 的物理极限。因为 RSI 现在被炒作得几乎像是一个没有终点的系统,我们可以一直加速,直到无限。这里的炒作是什么?虚构的部分在哪里?
杰夫·迪恩:如果你想想人类是怎么提升模型能力的,这就是过去 10 到 15 年一直在发生的事。你把真正有能力的研究者和机器学习工程师聚在一起,他们在小规模上跑很多实验,他们说,哦,这些想法不行,这些想法行,然后我们把它们吸收进下一代模型。
Gemini 2 就是这样在 Gemini 1 之后出现的,我们跑了很多实验,改进了东西。所以这是研究和工程的一个正常过程。
当你开始把自动化用到这上面,是的,你能在速度上得到一些改进。人们会开一个实验,实验在凌晨两点结束,他们到早上八点才回到桌前看结果。
所以如果你有一个自动化系统,它能看结果,能以更自动的方式判断下一步做什么,也许能在整个大项目范围内做出比每个人各自判断更好的决策。但如果你想想创造一个基础模型并让它变好需要涉及什么,有大量实际的训练和实验要做。
而那不会以无限快的速度发生,对吧。这里就是有实际的物理限制:你需要跑一些计算,你需要看结果,计算机得把活干完,你需要保存数据,看结果,让另一个模型看结果,才能决定下一步做什么。
所以我觉得有些人有一种错觉,以为你能把这个循环跑到无限快。我只是觉得那不太可能。有自动化系统去尝试改进东西,肯定会提升我们改进这些系统的速度,但它不会让它们无限快。
李飞飞:我认为这是一个非常重要的点。其实,我当时并不是在申请 Discovery Loop 的工作,但我和 Jeff 一起在 Cafe Venetia。我们喝咖啡有很多原因,因为我们喜欢咖啡。而且我们一直在聊 RSI 的炒作和事实。我们其实是在为这场对谈做准备,显然是这样。但我在想,好吧,这件事我还没跟你对过,你告诉我你同不同意,你不同意也完全没问题。
我在想人类。我们是一个自我改进系统,还是一个 RSI 系统?我认为我们绝对是自我改进系统。我做饭很烂。如果我要试着做个煎蛋卷,第一次我肯定把什么都烧了,然后我会学到,第二次会好一点。也许十次之后我能做出一个还行的煎蛋卷,我会吃,我的孩子不会吃。这就是自我改进。
但 RSI 的部分跟我的大脑有关。在学习做煎蛋卷的过程中,首先我的大脑必须以某种方式被改变,一些神经连接需要被改变到足够的程度,让我有一个更好的系统来做煎蛋卷。如果谈硬件改进,也许我能长出第六根手指。
杰夫·迪恩:也许你是 AI 生成的。
李飞飞:正是。然后通过做更多煎蛋卷,我的大脑会进一步改进。如果这个循环成立,人类就是一个 RSI 系统。这个类比对吗?
杰夫·迪恩:我想答案是,人类两者都是。在你的一生中你学到很多东西,那是自我改进,比如你学会做煎蛋卷,学会做微积分题,但你也在学习如何学习。而那种「学会如何学习」,其实正是让你成为自我改进者、也让你成为递归自我改进者的原因。因为现在你可以基于「什么样的知识、以什么方式呈现给你,能让你最有效地吸收」的理解,更快地学会更多东西。
李飞飞:对。而递归自我改进可能本质上就是一种进化算法。总之,我不想掉进兔子洞,但我觉得能公开做这个讨论是难得的机会,因为现在炒作太多了。
杰夫·迪恩:关于「它会无限加速、很吓人」这类炒作有很多。如果你把它看成一个务实的工程系统在做事情,它就没那么吓人,也更容易理解。
李飞飞:对。你讲了很多 Discovery Loop,但你对想解决什么科学问题还是有点含糊。所以我想稍微推你一下,在你愿意透露的范围之内。科学问题太多了,都是有益于社会的。你现在最热衷的是哪一个?
杰夫·迪恩:我很久以来对 AI 用于医疗非常有兴趣。我认为那是一个我们会去做的领域,不是现在,是往后,因为我觉得那是一个极其重要的领域,也非常符合我们公益公司的使命。
现在,我们专注于那些整个循环都能以数字形式完成的科学与工程问题,因为那类问题最适合把整个循环加速。如果有实际的物理过程参与,要把循环加速就更难。
显然有很多重要学科需要物理过程,我们有一些混合的方法,可以在那些领域把速度提上来。所以先看科学与工程里的数字领域:我们最初专注在机器学习研究本身、机器学习工程本身,还有硬件设计。手上有几个不同的专注方向是好事,不要试图什么都做,而这几个正好是我们自己有领域专长的方向。我们认为这是一个非常重要的领域,因为它会解锁别的东西。
举例来说,在医疗里,如果你有一个能自动解决机器学习工程任务的系统,你就可以把它指向健康领域的很多问题,或者材料科学之类的,然后说,我想要一个专门针对这个任务的、了不起的模型。那是一种自我改进,但不是递归自我改进。所以这就是我会怎么描述我们自己:现在专注这三个领域,但有走出去的雄心。
李飞飞:我本科是学物理的。在物理里,我们有实验家和理论家的分工,对吧?我刚才就在想你画的这个循环。你叫它「提出实验」,但在物理里我们更倾向于叫「假设」,形成假设,然后你通过实验和评估等等。
我刚才在想,强大的 AI 智能体,或者这些自我改进循环,不管是不是递归的,都无所谓,它是不是在哲学上采取了一种更偏实验、偏实验主义的立场来看待科学问题?因为它非常强调提出假设和并行实验,而不是那种更神秘的、理论式的科学发现方式。到今天你还会想,像牛顿、爱因斯坦这样伟大的理论家,他们并不做那么多实验。他们读实验,但他们不是那样做的。所以你觉得这是不是在往实验主义倾斜?
杰夫·迪恩:我不觉得一定是,但可能确实更偏向那个方向一点。我确实认为,用这样的系统也能做很好的理论工作。你可以这样要求它:你能不能想出一个能解释所有这些数据的理论。然后它可以在其中反复迭代,试着找出一种最简的理论,用来解释这些实验数据。很多理论物理学家会看物理学界在实验领域发生了什么,然后试着提出理论,去解释人们已经观察到但还不理解的一些东西。所以我认为那当然是可能的。
而且我认为,把这些看成彼此分离的学科其实不好,理论物理、实验物理、化学都一样。如果你想想一个系统,比如说它已经解决了一百万个问题、做了上亿次实验、横跨一百个科学领域,那么它很可能会有很多洞察。这些洞察来自它见过的大量实验结果,也来自它在亲缘问题上试过什么可行、什么不可行,而你未来要它解决的问题,多半就在这些亲缘问题附近。我认为这种东西没有硬的领域边界,不像我们人有时硬加上的那种学术系科边界。我喜欢 HAI 的一点就是它像一个跨机构的东西,让所有人一起说话。
数学的海啸,与一场突击测验
李飞飞:那我们得聊聊数学了。其实,当我们提议邀请你来这场对谈时,我本来是要请陶哲轩的。所以我给他打了电话,但他来不了。
那我们就聊一点数学。我得说,看到那一系列结果的时候,我心情很复杂。先是纳维-斯托克斯方程,然后是 720,你知道论文,然后昨天 OpenAI 又刚发布了更多关于 AI 解决数学问题。
这显然不是说我不喜欢那些被发现的数学结论。只是数学,和那些百年、千年的数学问题,是人类智能的顶峰。数学家在其中看到的不只是技术解法,他们还看到美。而现在我们有了完全不同的机器来处理这些问题,对吧。
杰夫·迪恩:显然,这些模型有能力解决数学里真正难、开放、尚未解决的问题。还有一些基于智能体的系统,能在高度并行的智能体活动里调用这些模型,它们同样做得到。这是对现在能做到什么的一种揭示。
我认为人们会觉得这不太令人满足、甚至有点不舒服,因为那些证明常常涉及五百页的 Lean 之类的代码。所以它是机器可检验的,但没有人真正理解通往那个结果的优雅、简单的路径。
所以我认为,知道这个问题被证明或被证伪是好事,但人类数学家跟问题搏斗的时候,往往在做另一件事:发展出真正优雅的技术,抵达那个结果。而那些往往会产生新的数学,可以用来攻别的问题。
李飞飞:你是说,新的数学解法只来自优雅的解法?
杰夫·迪恩:不是,但我想那种优雅的解法往往带来一个很酷的技术,然后这个技术可以用在别的问题上。而这些非常长的、机器生成的证明里,我不认为人们一定能看到那种清晰、优雅的技术。
但知道某件事是可解的,在很多不同领域其实都是这样:如果你知道某件事是可能的,你反而会更努力,会明白你能做到,然后你也许能以另一种方式、或者更优雅的方式真正做到。所以我认为,是的,这么多问题同时被解决,某种程度上让人不安。但我确实认为,那现在已经是可能的了。所以人们得想清楚,我们怎么利用这个能力去做更多数学。
李飞飞:我们可以聊更多这个。但我答应过 Jeff 要在台上给他一个突击测验。我没告诉他题目是什么。但你答不出来也没关系,因为我自己也不记得。
你记得这个日期的意义吗?2017 年 6 月 12 日。不许用 AI 作弊。
杰夫·迪恩:哦,是那篇 arXiv 上的 Transformer 论文吗?
李飞飞:太厉害了。A+。就是这个,我还得去查是哪一天。你在 6 月 12 日读了那篇 Transformer 论文吗?
杰夫·迪恩:没有,大概是 6 月 10 日。
李飞飞:哦,对,是这样。那篇论文大概还得你批准。
杰夫·迪恩:对。
哪一步最关键,哪些预测错了
李飞飞:所以,你这一路,我想稍微回顾一下。我们可以聊很多。你有一页幻灯片展示了你们四个人在 Google 和在我们这个领域一起做了那么多事。但我们就用那个日期作为一个历史节点,某种意义上的生成模型时代的开端。
就跟我们分享,在这将近十年、九年多的旅程里,在你心里,也许我们没时间全说,但对你个人来说最重要的技术时刻是什么。我还想接着问,在智识上,说实话,你哪些预测对了,哪些预测错了?
杰夫·迪恩:让我想想。在我们取得的所有重大改进里,有几件事比较突出。就像那张幻灯片上列的所有那些进展。我认为,处理这些问题,Transformer 显然是效率高得多的模型架构。
它背后是一个非常了不起的洞察:把所有走过的状态都保存下来,然后对它们做注意力,而不是每来一个状态就用一个小向量去更新、把之前的全部忘掉。这个洞察带来了很多进展:比起早期基于 LSTM 的模型,现在的模型能用少得多的计算学到多得多的东西。
还有 Oriol、我和Hinton 做的蒸馏工作。它当年其实被 NeurIPS 2016 拒了,理由是「不太可能有什么影响」。我们把它扔到了 arXiv 上,它现在大概有四万次引用。
所以我认为,那对做出真正有能力、推理高效的模型是关键,因为你可以拿一个你训练好的、非常大、非常笨重、非常贵的模型,把它当作老师,去教你现在这个轻巧灵活的学生模型。这话在大学里说挺合适。所以那很好。
李飞飞:我们应该有个网站,把所有被拒的论文收集起来。
杰夫·迪恩:对。那个成果还挺不错的。
MoE 架构,我认为已经被证明是好的。我原本以为,那会是一系列更加奇特的模型架构的开端。你知道,MoE 架构是你分叉到一堆专家,然后汇回来,然后再分叉,再汇回来,并学习哪些专家擅长哪些事情,这非常有用。它给你的模型很大的容量,但对任何给定的 token 或任务,你只激活其中很小一部分。但它仍然非常规整。比如在大多数 MoE 里,所有专家大小相同,它们立刻又汇到一起。
我以为接下来会出现大量真正狂野、奇特、看起来更像生物大脑的架构:一列列的神经活动,它们汇回来,还有一些非常稀疏但很大的跨连接,能把你神经网络远端的部分连起来。但我们还没走到那一步。我们在神经架构搜索里想过这个,那也没成。
对,神经架构搜索出来的模型确实看起来比人类设计的更有机。人类设计的模型就是一堆层,偶尔每层加一个跳连。神经架构搜索出来的会有那种疯狂的连接,把这一层连到上面第 17 层,做点奇怪的事。
李飞飞:所以那就是你认为自己预测错的一件事?
杰夫·迪恩:嗯,我预测错了很多事。但那件比较突出,我以为 MoE 的推进会更多往那个方向走。我还认为,编程能力被证明非常重要。我当时并没有预见到,它会是那个关键解锁点,让这些模型真正有能力解决很多不同种类的问题。
李飞飞:这个我同意你。我们都多少知道,但没有预测到它深刻到什么程度。
杰夫·迪恩:所以,在 Gemini 那个项目里,它是我们关注的事情之一,但它不是我们关注的那件事。
最担心的那件事,不是技术问题
李飞飞:有一件事显然我们稍微聊过一点。我们在 HAI 的会议上,所以必须聊聊那个 H 字。
我想知道你当年有没有预测到,以及你现在怎么看,就是 AI 的社会影响。而且不只是影响。影响的一部分是工作,是心理焦虑,是现在关于人类灭绝、对齐之类的几乎极端的讨论。首先,哪一个最让你担心?
杰夫·迪恩:这是一项极其强大、极其通用的技术,它正在影响社会的几乎每一个方面。它在数学、编程、生成图像、帮自动驾驶开车这些事情上都能做。过去的技术革命范围相对更窄,通常只深刻地影响五个或十个领域,而这一项不一样,它同时影响着世界上非常非常多的事情。它既让人兴奋,也让人忧虑、恐惧,什么情绪都有。
我其实和一组了不起的共同作者写过一篇论文,叫《塑造 AI 对数十亿人的影响》。我发过那么多论文,只有那一篇有专门的网站,因为我们有一位很有灵感的共同作者,shapingai.com。我们实际看了七个不同的领域,包括就业与经济、AI 用于科学、错误信息、虚假信息、媒体,还有其他几个领域,跟每个领域的很多专家都聊过。我觉得那是一段很好的经历,因为我们拿到了他们的视角,看 AI 已经如何影响他们的领域,以及未来可能如何影响。
我最担心的,是怎么在这么多不同领域里尽量多拿到 AI 的好处,同时把它可能造成负面影响的那些领域的坏处压到最小。这不纯粹是一个技术问题。它是技术问题,也是监管者和政策制定者的问题,是公民的问题。我们所有人都得想清楚,怎么在这项新技术里航行,确保它很好地服务我们所有人,而不是以我们认为可能的方式伤害我们。还有,比如当人们的工作受到影响时,他们要有一个好办法去适应这个世界现在需要的能力,能有报酬不错的工作,能过上富足的生活。这是一件多方面的事,需要世界上很多人一起去解决。
李飞飞:那么,这是我的最后一个问题。我知道一件关于你的事,Jeff,大多数公众不知道,就是你有多在乎年轻一代。
我们不太常同台,但在我记忆里,我们上一次一起参加会议是 Grace Hopper 大会。你去了好几年。所以现在我们在一个大学校园里。说实话,这一代大学生很焦虑。连斯坦福的学生都在焦虑工作,焦虑经济的未来。而作为一个有着如此成功职业生涯的人,作为 AI 的先驱,也作为一个能看到公众还看不到的未来的那种人,你对台下这些感到焦虑、同时也可能怀着希望的学生,有什么临别的话?
杰夫·迪恩:我完全理解这种焦虑,因为世界变化很快。如果你在为未来做规划,为一个快速变化的未来做规划是非常难的。
所以我一般给的建议是,试着去理解什么新技术正在开始出现、或者相对快就会存在,然后确保你理解怎么把这项技术用在你最有热情的那件事上。那可能是去当医生,可能是去写文学作品,也可能是把软件写得更好。所有这些都是可以被 AI 帮助和赋能的,但人的那一部分还在:我们集体要做什么,得由人来想清楚。而你应该想清楚你想做什么,并在这件事上做到最好。这意味着用上现在所有可用的工具。
李飞飞:所以,在 AI 时代,人的热情依然是永恒的。谢谢你,Jeff。
杰夫·迪恩:谢谢你。
(转载自智能纪元AGI)
 扫码下载app 最新资讯实时掌握