2026 年下半年,大模型预训练的算力军备竞赛渐渐退居幕后。几乎所有头部实验室都把筹码推向了同一张牌桌:Agent 与 RSI(递归自我改进)。
一级市场和学术界都在讲模型自我进化的故事,试图用合成数据和强化学习接力枯竭的人类语料。但行业里一个心照不宣的事实是,绝大多数所谓的自我迭代,一旦离开代码生成和数学推理这两个拥有明确验证标准的温室,进入复杂真实的业务流,很快就会演变成一场“左脚踩右脚”的刷榜游戏。
Z Finance 注意到,基元律动近期正式发布了 NeoHorse-1.5-Flash Preview。
两个月前的 9 月,这家团队曾发布过 4B 和 9B 尺寸的 NeoHorse-1,并在 arXiv 上挂出了一篇引发不少从业者讨论的技术报告。当时他们只验证了一件事:一个部署在真实任务上的 Routing Harness,本身就可以成为模型观察自己、改进自己的机制。
仅仅两个月后,这套机制转进了第二圈。
在这次更新中,基元律动第一次把上一代模型放回真实任务环里,让它自己跑完闭环、产出下一代。模型的参数规模也直接拉升到了当前大模型最受关注的 Flash 档位。
在追踪并拆解完这款新模型的评测数据与底层架构后,Z Finance 看到了一条不同于传统大厂的演进路径:当单一模型厂商还在为后训练的边际效应递减而焦虑时,站在多模型路由生态位上的基元律动,正试图把 RSI 从论文概念变成一台工业化运转的机器。
125B Flash 档位上的性价比账本与代际跃升
从公开的技术参数来看,NeoHorse-1.5-Flash Preview 是一个纯粹的 Agent 原生模型,基于 Qwen 3.8 Flash 进行 RSI 进化,主模型参数 125B、激活参数 6B。
在最新公布的 Agent Last Exam(ALE)高难度榜单上,NeoHorse-1.5 实现了显著的跨领域代际提升。整体平均成绩提升了 9.23 分。其中,物理科学任务大幅提升超过 20 个点,医疗健康任务提升超 10 个点,工程任务提升超 13个点,其他领域也实现了 14.13 分的增长。
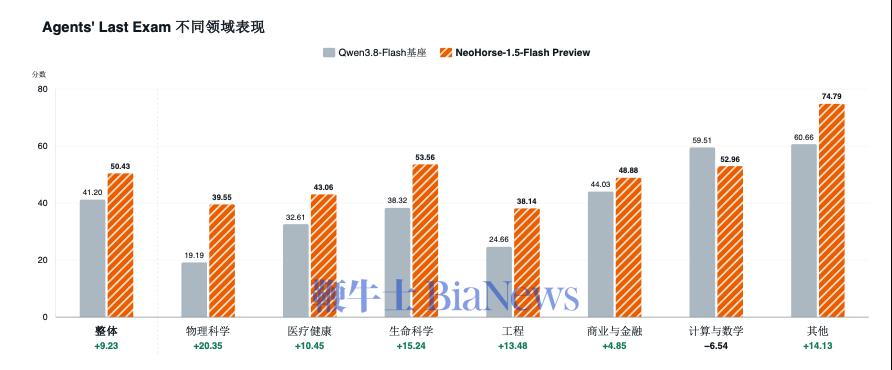
图1:ALE 榜单各领域表现对比图
另一项更贴近软件工程落地的 Natural Language to Repository(自然语言到代码仓库生成)评测,则体现了它在长链路工程上的表现。NeoHorse-1.5-Flash Preview 的整体得分从基座的 44.24 提升至 50.16(+5.92)。其中,安全认证与加密提升 12.71 分(35.68 到 48.39),Web 开发与内容获取提升 10.56 分(51.19 到 61.76),开发工具与测试提升 9.74 分(34.92 到 44.66),通用编程、文本处理、系统自动化与数据分析等维度也有 3.6 至 5.4 分不等的增长。
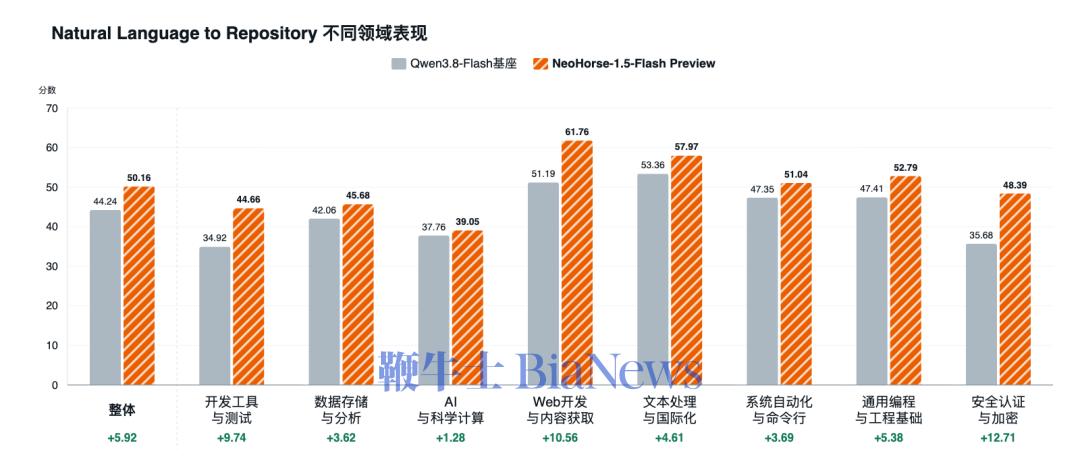
图2:Natural Language to Repository
谈及模型定位时,基元律动团队内部有一个很明确的共识:“不追求绝对 SOTA。”
他们的逻辑是在每个参数量级上把精度和性价比推到极限。这背后其实是一笔很现实的 Token 经济学账本。在真实的 Agent 工作流中,一次任务拆解、工具调用与多轮环境试错,动辄消耗数十万甚至上百万 Token。如果每次常规调用都动用万亿参数的旗舰模型,绝大多数商业场景的 ROI 根本算不过来。125B 总参数、6B 激活参数的 Flash 档位,正好卡在推理延迟、调用成本与复杂逻辑能力的平衡点上。
这种向机制要效率的做法,在两个月前的第一圈迭代(NeoHorse-1)中就已经跑通。当时,Routing Harness 为每个任务预估的能力需求,被顺手组织成了三阶段课程,省去了人工数据配比。实验对比显示,在同一训练配方下,Harness 积累的真实经验比公开 Agent 数据集平均高出 6.26 分,在 $$\tau^2\text{-Bench$$ 上高出 11.31 分;4B 模型均分从 58.94 提到 64.87,9B 从 65.60 提到 69.04。
到了 1.5 版本,团队把 NeoHorse-1 放回模型池继续服务真实任务,跑完一整圈后训出了 125B 的下一代。不仅前期的能力增益跨尺度保留了下来,而且第二圈转得比第一圈更快了。
实测拆解
刷榜分数只是账面数字,Agent 在真实生产环境里到底好不好用,取决于它能否在长链路的工程环境里把任务真正走通。Z Finance 测试了 NeoHorse-1.5-Flash Preview 与同量级基座模型(Qwen3.8-Flash-Next)在六个典型开源工程与业务场景下的同场实测记录。
在相同的输入和任务要求下,两款模型被置于完全一致的真实运行环境中,逐项比对从服务启动到最终业务交付的完整链路。
第一个测试场景是 Web 全栈开发中的经典任务——基于 Flasky 构建博客系统,要求走完“从首页访问到账号注册确认”的五步完整闭环(01 同一起点 → 02 打开注册页 → 03 提交注册 → 04 登录并确认 → 05 看最终交付)。
图 3:Flasky 博客案例实测对比
在第一步“首页可用”阶段,两边都能正常返回 200 状态码。但打开渲染页面就能看出差异:左侧的 NeoHorse-1.5 给出了带深色导航栏和基础排版结构的页面,而右侧模型只吐出了没有样式的原始 HTML 列表。往后走到提交注册和登录确认环节,工程完整度上的差异会直接影响多步状态能否顺利流转。
第二个切片对应了榜单里涨幅最大的“安全认证与加密”领域:基于 fastapi-users 实现“注册、登录,再查到自己”。
图 4:fastapi-users 账户认证实测对比
测试要求模型使用同一个演示用户,依次跑通启动服务、注册返回 201、登录返回 200、以及携带凭证读取“我的账户”返回 200 的全流程。这不仅考察代码生成,更考察 Agent 对异步接口状态流转、JWT/Cookie 鉴权传递以及数据库持久化的端到端把控力。
第三个场景切入“Web 开发与内容获取”中的高频痛点——基于 jusText 的网页正文提取。
图 5:jusText 网页正文提取实测对比
系统向两边输入同一篇混杂着顶部导航栏、促销广告横幅、内联 <script> 脚本以及社区花园新闻正文的复杂网页。任务要求经历清理脚本、识别标题、留下正文、检查缺陷共五个步骤,精准剥离噪音并保留干净的段落文本。
第四个与第五个场景,则将压力给到了“数据存储与分析”和“AI 与科学计算”。
在基于 pandarallel 的并行数据处理任务(“订单:逐笔金额如何变成合计 100”)中,模型面对三笔真实订单(Coffee 2×18、Tea 3×12、Cake 1×28),需要完成多进程初始化、逐项并行计算(36、36、28)并最终汇总为 100。而在基于 scikit-learn(sklearn)的“表格:六个数能否全部翻倍”测试中,模型收到一个三行两列的矩阵(1/10、2/20、3/30),必须在严苛的接口限制下(只提供 fit/transform,不提供 get_params)接入自定义转换器,让每一行数据准确乘以二。
图 6:pandarallel 订单并行计算实测对比
图 7:sklearn 矩阵转换器实测对比
最后一个场景考察的是“开发工具与测试”中的底层基本功——基于 icecream 库的调试打印(“调试:把表达式和 72 一起打印”)。面对 unit_price = 18、quantity = 4 以及 ic(unit_price * quantity) 的代码片段,模型需要依次完成选择依赖路径、AST 提取表达式、打印结果以及检查回退路径,确保不仅算出 72,还能把源码表达式精准地带出来。
图 8:icecream 调试打印实测对比
这六个测试案例并不算宏大,但挑的都是实际写代码时最容易卡壳的细节:依赖路径选择、API 边界限制、跨步状态保持。NeoHorse-1.5 在这些环节表现得更顺畅,很大程度上是因为它并非只在静态代码库里做问答,而是在真实的执行环境里被反复打磨过。
横亘在 RSI 路上的三座大山
在真实的工业界,跑通第一轮自我改进并不难,难的是让飞轮“持续”转下去。
RSI 的理想闭环很直观:用户给任务 -> 模型做题 -> 验证 -> 训练 -> 更强的模型再接任务。但在通用 Agent 领域,第二圈绝不是把第一圈原样重跑一遍。挡在模型团队面前的,主要有三座大山。
第一座山是“自我诊断盲区”,断在验证环节。
写代码有测试脚本,做数学题有标准解,但真实的办公、操作浏览器、GUI 交互这类任务,没有非黑即白的标准答案。如果妥协用“模型当裁判”(LLM-as-a-Judge),很容易被 reward hacking 绕过去——得分点看似全满足了,任务其实没完成。更底层的矛盾在于,模型不知道自己不知道什么,自己给自己打分,系统根本不清楚下一步该往哪个方向进化。结果往往是 benchmark 越刷越高,真实体验原地踏步。
第二座山是“分布坍缩”,断在任务来源。
目前人类公开的高质量数据基本见底,公开的 Agent 数据集同质化严重。如果让模型在封闭环境里自己出题、自己做题,数据分布只会越收越窄,陷入经典的 model collapse(模型坍缩)。而如果单纯靠蒸馏一个更强的闭源模型,本质上只是追赶,上限永远锁死在老师之下。翻不过这座山,模型能力很快就会在一个狭窄的分布上饱和,换个真实场景就不会了。
第三座山是“迭代效率”,卡在沉重的训练流程上。
传统的模型迭代,每转一圈都要经历重建环境、大规模合成、全量评测、离线重训。每一步都在烧卡、烧时间,更需要算法工程师全程盯着调参、决定下一步配比。等一圈离线流程跑完,几个月过去,外部的用户需求和前沿基座模型早就变了。这也是为什么很多 RSI 方案只停留在论文里,走不到生产线上。
这三座山,决定了 RSI 究竟只是一个漂亮的概念,还是一台真能转起来的机器。NeoHorse-1.5 的第二圈,主要就是围绕这三座山搭起来的。
生态位优势与三张技术牌
在看具体技术动作之前,需要先理解基元律动所处的生态位置。
RSI 飞轮要持续运转,核心燃料是“外部的新鲜信息”——也就是模型自己产生不了的那部分。单一模型厂商之所以容易陷入瓶颈,是因为他们只能看见自己的模型。而基元律动做的是一个“多模型 $$\time$$ 多 Harness”双重接入的路由平台。
目前国内市场里,有做多 Harness(覆盖代码、办公、浏览器、GUI 等执行环境)但只绑定单一模型的团队,也有做多模型聚合路由但只有单一 Harness 的平台,把两头都接起来的很少。
因为双重接入,基元律动的 Routing Harness 每天在真实任务上调度整个前沿模型群体。这种路由视角,让他们可以在同一个任务切面上看到:每一类任务谁强、谁弱、差多少。同时,NeoHorse 以 Preview 形态混在模型池里,与全球前沿模型同场干活,配合团队自建的合成环境库与内源评测集,顺理成章地解决了两个前置问题:有没有可比的参照系,有没有外部的新鲜分布。
图9 :RSI 飞轮全景
有了燃料之后,基元律动在飞轮的诊断、环境、训练三个位置上,分别用了三项技术来对应前面的三座大山。
针对“自我诊断盲区”,他们做的是“多模型差分诊断”。
这个模块的底座,是其自研 Harness OpenSquilla 已经上线的多模型融合功能。一个任务进来,不是交给某一个模型,而是由多个前沿模型同场作答、再融合成一个更好的结果。这个功能原本是为了保证线上交付质量,但它的副产品恰好成了 RSI 需要的参照系:在融合过程中,每个模型分别做到了什么、融合后的最优解是什么,天然形成了一组逐任务可比的标尺。
把 NeoHorse 放进模型池里,系统就能通过 Aggregator 在线差分,持续刻画它与各个前沿模型的能力差距,生成一张动态的“能力缺陷画像”。传统做法是拿静态榜单打分,他们是拿整个前沿模型群体当参照。这张画像直接决定下一轮训练往哪使劲——保住已有优势,补齐真实短板,配合按真实任务分布生成的内源动态评测,不再对着榜单均匀撒数据。验得准、方向对,这是第二圈比第一圈快的第一个原因。
针对“分布坍缩”,团队搭了一套“对抗式环境进化引擎”。
在这套系统里,环境不是建好就固定的靶场,而是一个会自己繁衍的种群。引擎通过主动式环境繁衍实现“一拆多”,由一个种子环境衍生出多个不同难度的候选。每一轮都用“模型能不能做出来、认不认得出”作为筛选压力,淘汰太简单和太熟悉的题目,留下能把分布往外推的任务。
同时,模型在环境里面对的不再是写死脚本的提问者,而是会追问、会改需求、甚至会反悔的“数字镜像交互体”。多轮任务的分布因此更贴近真实的人类需求,避免了分布坍缩和能力早早饱和。
针对“迭代效率”,核心改动是“群体智能在线学习”。
在算法层,NeoHorse-1.5 换了一种更直接的更新方式。监督信号依然来自 OpenSquilla 的多模型融合:同一个任务上,NeoHorse 自己的作答与多模型融合结果之间的“群体差分”,就是一份现成的、逐任务的教师信号。相当于不是某一个固定老师在教它,而是一群老师同时在场。
模型在线上服务真实任务的同时,直接拿这份群体差分当老师,on-policy 地持续更新自己。诊断和训练共用同一个差分信号源,既告诉系统差在哪,也直接教模型怎么补,同时保留了第一圈验证过的路由引导课程学习与离线 RL 作为底座。而在训练 Infra 上,团队把 RSI 的思路用到了工程本身:让 AI 自动改写与调优算子,多个 AI 分工值守训练集群、自主决定下一步优化点。第三座山的本质是“人是瓶颈”,他们的解法是把人从繁琐的运维环里拿出来,让环自己转。
结语
纵观这套架构,诊断决定方向,环境提供新鲜分布,训练以更高效的方式将经验训回模型。三大技术打在飞轮的三个位置上,全部共用同一个信号源——TokenRhythm × OpenSquilla 智能路由给出的课程信号、多模型融合给出的群体差分。不难看出,这是一套高度依赖其多模型路由平台生态位,才得以跑通的组合拳。
回看过去两个月的演进,NeoHorse-1 证明了 Harness 可以是 RSI 的机制。NeoHorse-1.5-Flash Preview 证明了这个机制可以转第二圈,而且第二圈比第一圈转得更快。
在大模型下半场,单纯靠堆砌算力和人力去“炼”一个静态大模型的边际收益正在急速递减。对基元律动而言,第二圈显然不是终点,而是起点:从现在起,每一代 NeoHorse 都会被放回环里,去产出下一代。
(转载自Z Finance)
 扫码下载app 最新资讯实时掌握