10 月 19 日到 22 日,短短 72 小时里,全世界的开发者调用 MiniMax 的 M3.1 Flash 消耗了超过 100 万亿 token。
平均下来,每秒 3.9 亿个。
去年 12 月,OpenRouter 和 a16z 合写过一份行业研究,拆的是这家模型路由平台近两年的真实调用,样本超过 100 万亿 token;而按 Epoch AI 此前的估算,人类在公开网络上写下、且质量够格拿去训练模型的文字,折算下来一共大约 300 万亿 token,M3.1 Flash 这 72 小时处理的 token,相当于它的三分之一。
在编程工具 OpenCode 上,M3.1 Flash 平均每个会话要消耗 150 万 token。照这个数字折算,100 万亿 token 背后是大约 6700 万个会话,每个会话里,都有一个 Agent 在后台一步接一步地干活,错了就推倒重来。
10 月 23 日 MiniMax 的 M3.1 Flash 正式开放权重。
这是 MiniMax 迄今最强的模型。在 Artificial Analysis 智能指数上,它比四个月前的旗舰 M3,足足高出十几分。
一家公司舍得把最好的刀递出去,是因为它根本不打算靠卖刀赚钱。MiniMax 真正想要的,是让全世界的 Agent,默认跑在它的模型上。
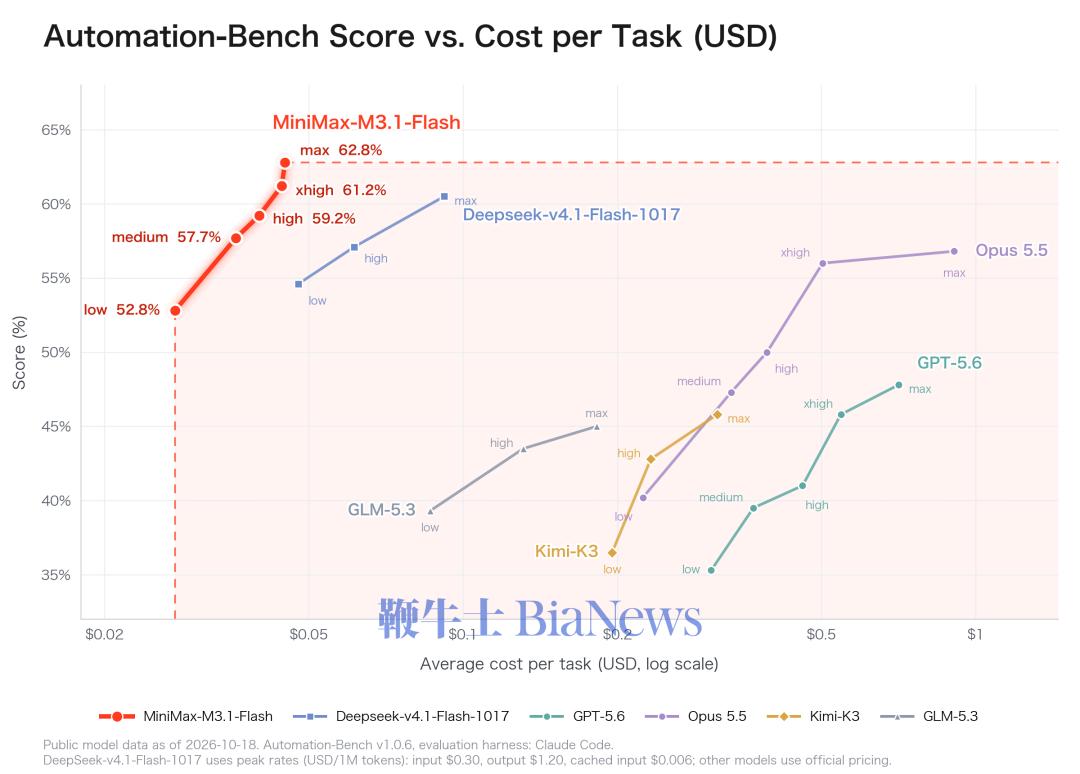
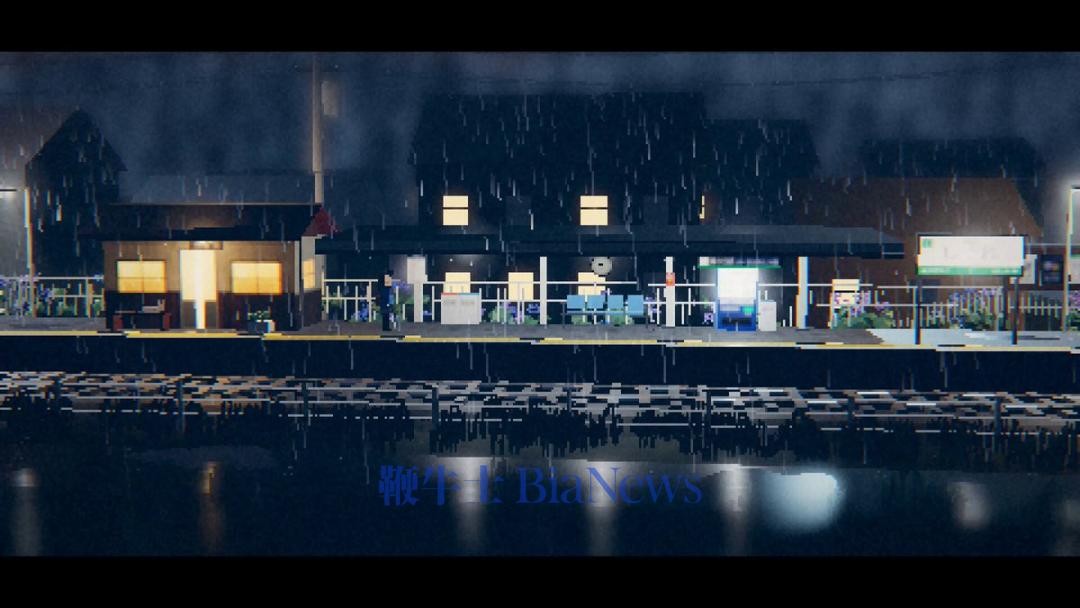
兔子 最早,M3.1 Flash是匿名发布的。 9 月 23 日,一个叫 Space Bunny Alpha 的模型出现在 OpenRouter 上,输入和输出统统免费,也没有任何机构署名。同一天,编程工具 OpenCode 宣布免费开放使用一周。 好奇的开发者很快开始猜它的来历。有人拿 50 组字符串去测它的 tokenizer,结果切出来的 token 数量,和 MiniMax 从 MiniMax-01 到 M3 的 8 个历史模型全部对得上。 上线 6 天,OpenCode 上已经有 20 万人用过它,跑完 1230 万个会话。那时每个会话平均用掉 370 万 token,97% 的输入命中缓存。 9 月 27 日,MiniMax 给自家订阅用户放出了 M3.1 Flash 的预览版,公告里完全没提到 Space Bunny。 这只来路不明的兔子在 OpenRouter 上连续十天霸占调用量第一,单平台跑出 56.7 万亿 token,创下 OpenRouter 匿名模型的最高纪录。 OpenRouter 后来公布了匿名期前后的服务数据,靠着这十几天高并发攒下的真实反馈,模型的首 token 延迟从 1.95 秒压到了 1.22 秒,出错率也从 1.4% 降到了 0.7%。 10 月 19 日,MiniMax 官方账号发出一句「Welcome back. Space Bunny.」,正式认领了这只兔子。匿名期里算上各个渠道,这只兔子一共消耗了超过 200 万亿 token。 图源:X 模型卡上排在最前面的两项评测,都是让 Agent 干白领的活。 BankerToolBench 是今年 4 月才推出的。Agent 要在数据室、市场数据平台和 SEC 文件库之间来回翻找,交出投行初级分析师要做的 Excel 模型和 PPT,再由银行家写的细则逐条打分。这个测试刚推出的时候,连表现最好的 GPT-5.4,都有将近一半的细则没达标。 M3.1 Flash 在这一项上拿了 76.2 分,和 Opus 5 打了个平手。在 Automation-Bench 上,它拿了 62.8 分,排名第一。 模型没有缩水,但用起来的成本却实打实地降低了。 图源:MiniMax 模型卡列了三处改动,全是冲着推理效率去的。M3 留下的前三层全注意力,换成了稀疏注意力;MoE 的路由专家(共享专家除外)通过量化感知训练(QAT),提前适应 W4A4 精度,稀疏注意力索引器和主分支也从 Q8KV8 迁到了 Q8KV4;第三处是 Power-aware scheduling,通过对计算卡功耗的精细分配,让硬件持续维持在高算力运行状态。 Artificial Analysis 跑完算出 M3.1 Flash 完成一个任务平均花 0.22 美元,而 M3 要 0.51 美元。比旗舰聪明,并且做完一个任务的钱还不到旗舰的一半。 省下的钱,主要来自价格。M3.1 Flash 每百万 token 输入收 0.15 美元,输出收 0.6 美元,正好是 M3 的一半。 缓存又把成本往下压了一层。命中缓存的输入,每百万 token 只收 0.015 美元,是正常价的十分之一。按照 OpenCode 上那 96.4% 的命中率来看,会话拉得越长,平均每个 token 就越便宜。 地基 按常理说,手里捏着这样一个既强又省钱的模型,最顺理成章的做法是留着自己卖,但 MiniMax 没有留。 单靠按 token 收钱,这门生意的账只会越算越薄。 Mozilla 今年 7 月的开源 AI 报告引过一组数,2025 年 5 月到 9 月,OpenRouter 上的开源模型跑了大约两成的用量,却只分到 4% 左右的收入。M3.1 Flash 在国内每百万 token 的价格,也已经被卷到了输入 1 元、输出 4 元。 MiniMax 并不缺钱做模型。今年上半年它的研发开支 2.97 亿美元,比去年同期多了一倍多。8 月业绩会上,管理层交过底,说现金储备已经超过 30 亿美元。 同一场业绩会上,闫俊杰被问到开源会不会伤商业化。他的回答大意是,一个模型长期的定价能力,取决于效果、成本和稳定性,再加上迭代速度,和开不开源关系不大。 迭代速度恰恰是 MiniMax 最拿得出手的本事。过去一年,它在 Hugging Face 上发了六版文本模型,从 2025 年 10 月的 M2 到今年 6 月的 M3,每两版之间只隔五十多天。 权重可以整个送出去,造下一版权重的团队和训练框架,始终留在 MiniMax 自己手里。 模型在 MiniMax 这里是地基,真正能创造更大想象空间的,是盖在上面的东西。 默认 今年 1 月 9 日,Anthropic 不再让 OpenCode 和 Cline 这类第三方编程工具,用 Claude Pro 和 Max 的订阅账号登录。你想用订阅额度拿 Claude 写代码,就只能用 Anthropic 自己的 Claude Code。 这一关门,就把全世界的第三方工具都拒之门外了。九个多月后,OpenCode 上跑得最多的,已经换成了中国模型。上周用量排名前二的,是 DeepSeek V4.1 Flash 和 M3.1 Flash,其他排名靠前的还有 GLM-5.3-Flash 和小米的 MiMo-V2.6-Flash,全是中国的 Flash 模型。 MiniMax 野心很大,他们想让自己的模型成为所有工具的默认选项。 MiniMax 准备了很久。从 M2.5 开始,它就在训练框架 Forge 里,放进了 10 万多个外部 Agent 脚手架和真实环境,OpenCode 被直接当成黑盒,塞进训练循环。 到了 M3.1 Flash,模型卡上 15 项评测里,有 6 项是在 Claude Code 和 Codex 里跑的,那是两家美国对手自己的 harness。 MiniMax 苦练的本事,是让自己的模型不管在谁家的工具里,都能把活干完。 图源:MiniMax M Plan 订阅的官方文档里写着,它可以接进 Claude Code 和 Codex,也可以接进 Cursor 和 OpenCode。 权重开源当天,Together AI 和 Fireworks,加上 Nebius 和 Baseten,还有 Modal 和 DigitalOcean,六家海外推理云同步上架。 开源模型离最前沿平均还差四个多月,可一旦钻进开发者的工具链成了默认模型,别人想换掉它,就得重新调整提示词和 harness,缓存也要从头再来。 排行榜榜首两个月一换,但默认的位置可以坐很久。 墙外 往太平洋两岸看,中美两边的模型公司都在地基上盖楼,但盖法完全相反。 美国的模型公司,把楼盖在自家院墙里。 第一层楼,是把模型和自家的 harness 焊死在一起,收订阅费。Claude Code 今年 2 月的年化收入,超过 25 亿美元,Codex 在 6 月的周活跃用户,也超过 500 万。 再往上一层,是拿最强的模型,直接去高毛利的行业分钱。 OpenAI 的 Astra,先在内部解开了 10 道悬了十年以上的数学和理论计算机难题,捂了一个月,才分批对外开放;Anthropic 在 6 月宣布自研药物,OpenAI 的 CFO Sarah Friar 也在年初说过,想按新药的销售额分成,到了 10 月 20 日,OpenAI 直接收购了 Orchestra Bio。 盖这两层楼的前提都一样,那就是必须把最好的模型死死攥在自己手里。模型公司一旦亲自下场做应用,原来的第三方应用公司,一夜之间就成了它的对手。 于是被上游盯上的应用公司,都要找一个够好用,又不会反过来吞掉自己的底座。 美国人在院墙里盖楼,中国开源模型就把楼盖在墙外。 还是以 MiniMax 为例,9 月它把编程工具 MiniMax Code 以 MIT 协议开源。这套 harness 建在 OpenCode 和 Pi Agent 两个社区项目上,接别家的模型也可以。六天后,M3.1 Flash 的预览版,就先在 MiniMax Code 里开放给用户使用。 图源:X 视频那条线也一样。按公司的说法,H3 开源三周,下载量超过 2400 万次,社区在它上面又衍生出了 300 多个模型。 别人把模型锁进工具里,MiniMax 反倒把模型和工具壳子一起递了出去。 M3.1 Flash 的许可证允许商用,也允许微调以后,再拿去部署。用它做的产品和服务,年收入在 2000 万美元以内的,给 MiniMax 发一封邮件报备,再在网站显眼的位置,写上一行「Built with MiniMax M3.1-Flash」就行。 只有超过 2000 万美元,才要事先拿到 MiniMax 的书面授权。 Kimi K3 和 GLM-5.3 今年的新协议,会去拦拿权重去转卖 token 的云服务大户,Kimi K3 还写明嵌进终端产品或 harness 的不算。MiniMax 这条线划得更简单,不管拿去做什么,年收入在 2000 万美元以内报备一声就行,超过了标准之后才谈钱。 想到了《史记》里面记载的一个故事,冯驩替孟尝君去薛地收债。还得起利息的,他跟人家约好了日子。穷得实在还不起的,他把债券收上来,当众一把火烧了。孟尝君听说后很不高兴,冯驩说,烧掉那些收不回来的死账,薛地的百姓才会更亲近孟尝君。 2000 万美元以下的那些账单,就相当于是冯驩烧掉的那些债券。 全世界的初创公司可以拿这个模型免费去试错,一百家里死掉九十九家都无所谓。只要剩下那一家跑成了气候,收入超过了要求,谈判桌自然会摆到 MiniMax 面前。 8 月,MiniMax 的 ARR 超过 8 亿美元,2 月时还是 1.5 亿美元,八成来自企业。企业客户和开发者超过 200 万,是去年底的十倍。上半年的收入里,海外占了六成。 而谈判桌上的海外授权,今年多了一道国内的手续。 10 月 16 日,商务部和科技部发布 2026 年第 48 号公告,就修订《中国禁止出口限制出口技术目录》公开征求意见,拟把大模型、智能体和算力集群相关的 23 项人工智能技术列进去,出口前先要登记。中国模型出海会不会被收紧,外界一度有不少猜测。 商务部的答记者问,把边界划得很细。已经开源或者发表了论文的技术,不纳入管理,用受限的大模型对外提供 API、App 和 SaaS 服务,也不算大模型技术出口。人工智能技术开源,适用自动许可等便利措施。 10 月 22 日,据媒体报道,政策公布以来,DeepSeek 和 MiniMax 两家头部企业已顺利履行登记手续,完成了开源和海外授权使用。 中国的开源模型出海,从此有了第一批登记在册的正规军。 旷野 当然,这片旷野上不止 MiniMax 一家。 OpenCode 的周榜上,M3.1 Flash 排第二。第一是 DeepSeek V4.1 Flash,一周跑了 110 万亿 token,是 M3.1 Flash 的两倍多。 默认的位置,MiniMax 得先和几家中国兄弟抢一抢。 DeepSeek 和智谱的 Flash 也都开放了权重,DeepSeek V4.1 Flash 闲时的输入输出单价,和 M3.1 Flash 一模一样,只在高峰时贵一倍。 这条路很挤,但大家也都跑得极快。闫俊杰 8 月说,7 月 MiniMax 平台的 token 消耗量,是 1 月的 20 倍。 路上挤着的,还有那些被美国巨头关在门外的工具。比如 OpenCode 这样的编程工具没有自己的模型,大厂的订阅登录可以说关就关,但下载到自己硬盘里的权重,谁也收不回去。 海外那六家推理云,现在也在按 token 卖 M3.1 Flash。按许可证,拿它对外卖 API 一样算商用,这门生意一年过了 2000 万美元,也得回来找 MiniMax 拿授权。 太平洋那边,最强的模型越收越紧。Anthropic 最强的 Mythos,到现在也只给通过审核的网络安全和生命科学机构用。 M3.1 Flash 如今已经在天下人手里了。兔子上线第二天,日本创作者 yachimat 只用 Three.js,就拿它做出了一段 HD-2D 风格的动画。那时候,yachimat 还不知道这只兔子是谁家的。 图源:yachimat 拿它干活的人,大多也不在乎它是谁家的。他们在乎的,只是这个模型能帮自己那一摊生意做到多大。 欲取先予,把最好的刀递给天下人,天下人砍出来的疆土,最后都是你的版图。
(转载自洞察Beating)
 扫码下载app 最新资讯实时掌握