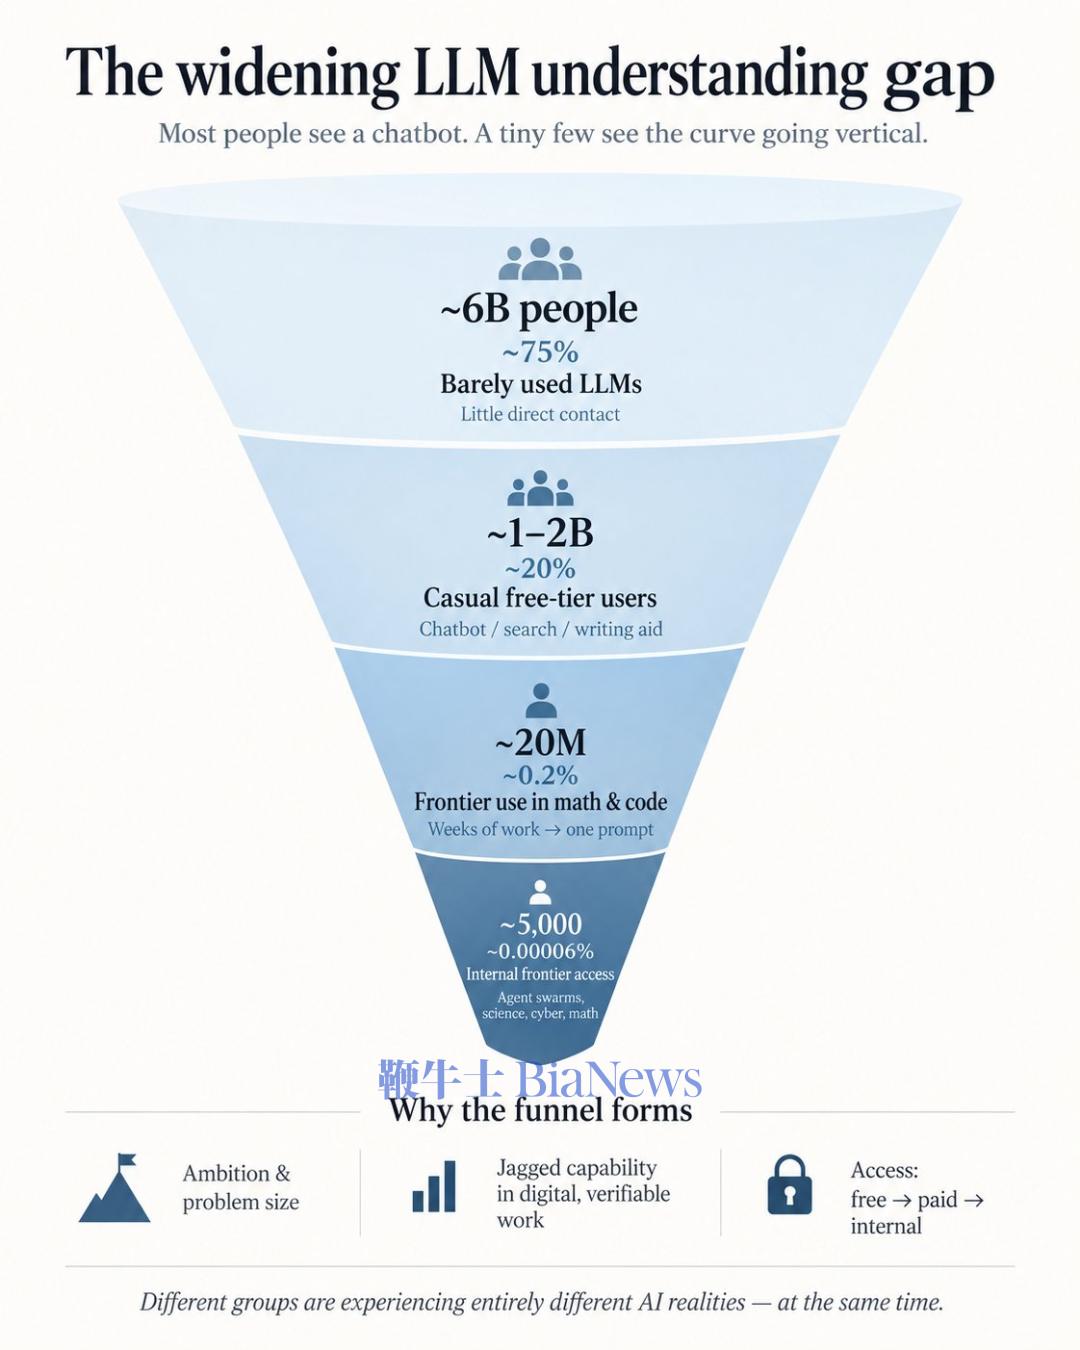
4月他曾表示人们对AI能力的理解存在鸿沟,两群人"各说各话"。今天他说:已经不是各说各话了,现在AI是一个"锋利的漏斗",把人类切成了四层。
- 约10–20亿人(约20%):免费版ChatGPT类产品的偶尔使用者;
- 约2000万人(0.2%):在数学、代码领域专业使用前沿模型;
- 约5000人(0.00006%):在内部直接接触前沿系统。
他指出,多数人只看见笨聊天机器人,一小撮人正在体验曲线变陡时的眩晕,这几件事在同一时间发生。卡帕西是 OpenAI 早期核心成员,当过特斯拉 AI 总监。离开大厂后,他仍一直公开讲模型、数据和智能体,在AI圈影响力巨大。
AI折叠成一个“锋利漏斗”
第一,很多人对AI的看法停留在"去年用过的免费版"。免费旧模型的幻觉和怪癖,根本代表不了当时的前沿agentic模型。第二,AI的能力分布是"尖锐"的:问答写作这种大众场景恰恰不是进步最快的,真正的突破集中在编程、数学这些有可验证奖励函数、商业价值高的技术领域。而且两种现实同时成立:免费的Advanced Voice Mode会在简单问题上翻车,而顶级的Codex可以花1小时重构整个代码库、甚至发现并利用系统漏洞。双方说的都是真话,但说的不是同一个AI。今天他认为随着AI的发展,这种对AI能力理解的差距在进一步拉大,形成了一个漏洞。最上面的大约 60 亿人,占全球人口的四分之三,他们几乎没碰过大模型。再往下,大约 10 亿到 20 亿人,偶尔用用免费版 ChatGPT。在他们眼里,这东西像好一点的搜索,或者帮着写两句。卡帕西说,他那些非技术朋友里,有人坦白自己几乎用不上,他觉得这话也合理。很多高管天天跟人开会,对 AI 听过不少,真上手仍隔着一层。继续往下,大约 2000 万人,百分之一的五分之一,在数学和写代码里认真用最强那一档模型。以前几周几个月的活,现在丢一句提示词,agent 就能干完。做应用、抄应用、翻译应用、从安装包反推源码,这些事最近一年变得很常见。卡帕西自己补了一句。不到一年前,他还在一个字一个字往编辑器里敲,偶尔按一下 Tab,补一小段。来到最后的大约 5000 人,能摸到实验室还没对外开放的系统。按他的说法,那一层已经是几千个 agent 一起干几周,啃超大软件项目,找安全漏洞,做网络攻防,甚至往科学和前沿数学里拱。人的审核开始跟不上。OpenAI 和 Hugging Face 那次出事过了好几个月,外面还在翻旧账。数学家也可能要啃很久,才能消化那 722 份前沿数学稿子。他表示,多数人看见的是有点呆的聊天机器人。多数上班族也只觉得方便了一点。只有很小一撮人,感觉曲线几乎竖起来了。
AI漏斗是如何形成的?
卡帕西认为有3个原因,它们叠在一起造成了现在的结果。随口问一句、要它回一段话,模型几乎使不上劲。手里得有一批又大又难、自己真着急的问题,差距才会露出来。普通聊天和专业干活,差就差在这儿。这意味着普通消费者和专业人士挖掘AI能力存在巨大的差异,普通消费者很难发挥AI的真正潜力。模型的能力是在可验证奖励的强化学习里长出来的。能赚钱、可验证的领域,AI能力特别突出。写代码最典型,这也是目前大模型最重要的能力之一,也是实验室重点研发的方向。而写作就好坏难判,所以我们经常看到模型升级了,可能写作能力反而下降了。所以搜索、写作、日常问问,并没有像写代码飞得那么快。就算你一个月花两百美元,用最好的模型,可能也没有想象中的那么好。第三,能用到什么档位,本身就不一样。免费的、花钱的、实验室内部的,它们本身就有巨大的差异。所以我们可能会看见这种怪现象。同一个模型,问它洗车怎么去,它可能答得很蠢。让它改十万行代码,它又能干得像样。
这对我们有什么启示?
我觉得有三点。第一,别再拿免费版的体验去争论AI行不行,否认你只能离真实情况越来越远;第二,真正的分水岭不是"用没用过AI",而是"有没有把模型用在正确的场景";第三,写代码、做研究的人,不能盲信AI,要做好安全防护。做内容、做管理、做业务的人,也不必因为别人喊天翻地覆就焦虑,很多日常场景本来就来得慢。
(转载自AI普瑞斯)
 扫码下载app 最新资讯实时掌握
 微信好友
 朋友圈
 鞭牛士公众号
 鞭牛士微博