大模型竞争,已经从“拼参数”进入“拼性价比”阶段。
9月22日,xAI发布了Grok 4.7。同一天,小米开源了MiMo-V2.6系列。到了23号,Anthropic推出Claude Opus 5.5。两小时后,OpenAI端出了GPT-6 Sol和GPT-6 Luna。
两天之内,五款模型,四家公司。更具戏剧性的是,就在这波密集发布前一周,Anthropic CEO达里奥还撰文呼吁AI前沿发展“放缓节奏”,主张安全实践应领先于模型能力。
尤其值得关注的是,这五款模型背后释放的共同信号——没有一家涨价,反而集体降价、加量、分层。而且这种价格战已经从通用模型蔓延到垂直模型,是全行业性的趋势。
9月23日,阿里千问正式发布Qwen-Audio-3.1系列语音大模型,五款全新语音模型最高降价幅度(95%),比通用模型(20%-50%)大得多。
新的信号已经出现,如果我们现在还只盯着跑分和参数,会容易错过真正值得说的东西。
先看价格策略的变化。
Grok 4.7的API定价维持每百万输入词元2美元、输出6美元不变,和Grok 4.6完全一致。
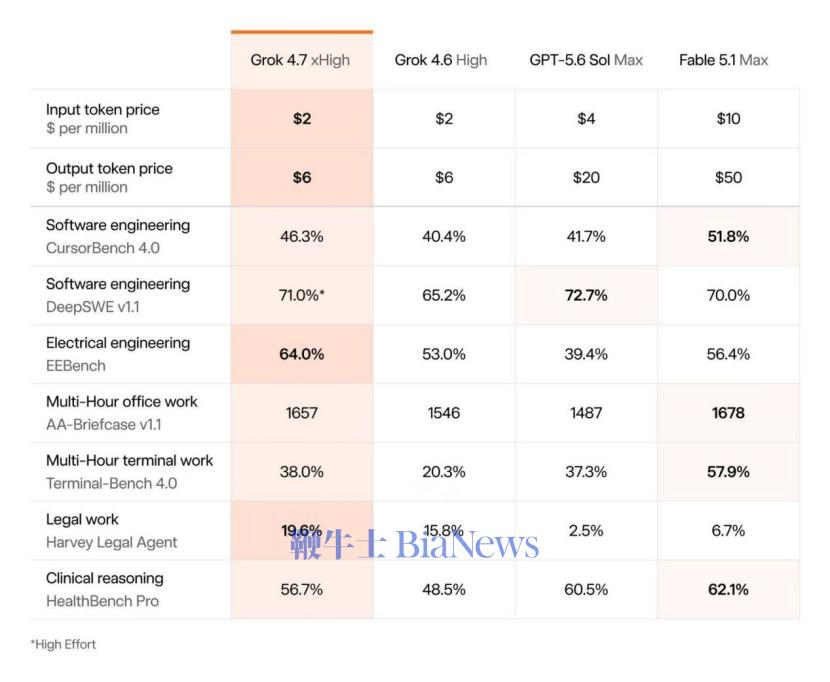
但性能上去了,官方称其采用比前代更大的新基座模型,经过更长时间的强化学习训练,专攻数小时级困难任务的自我校验与长上下文管理,其整体运算速度约为同类竞品模型的两倍。
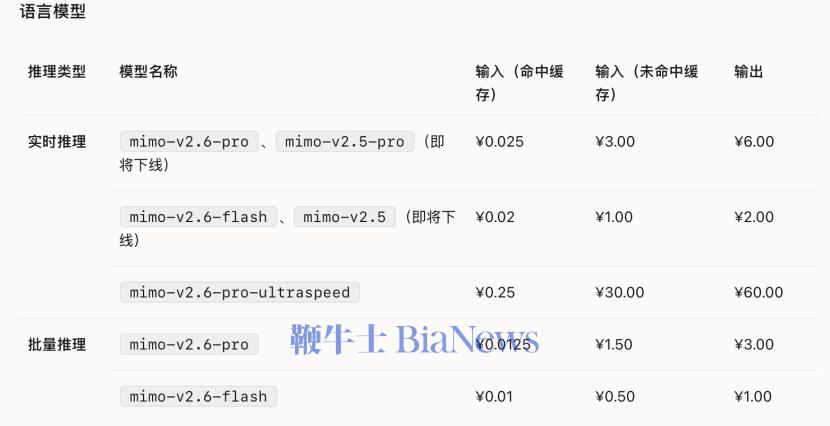
小米走的是另一条路。MiMo-V2.6系列沿用V2.5的API定价体系——Pro版每百万输入3元、输出6元,Flash版每百万输入1元、输出2元,同时提供99%的缓存折扣。
Artificial Analysis综合智能指数榜单上,MiMo-V2.6-Pro以46分登顶全球开源大模型第一,超过Kimi K3(44分)和GLM-5.3(45分),较其前代MiMo-V2.5-Pro的26分高出20分。小米官方同时说明,该模型与Claude Fable 5.1和GPT-6 Astra(均为53分)等顶级闭源模型相比仍有差距,事实上多位开发者也都反馈“v2.6没有那么聪明”。
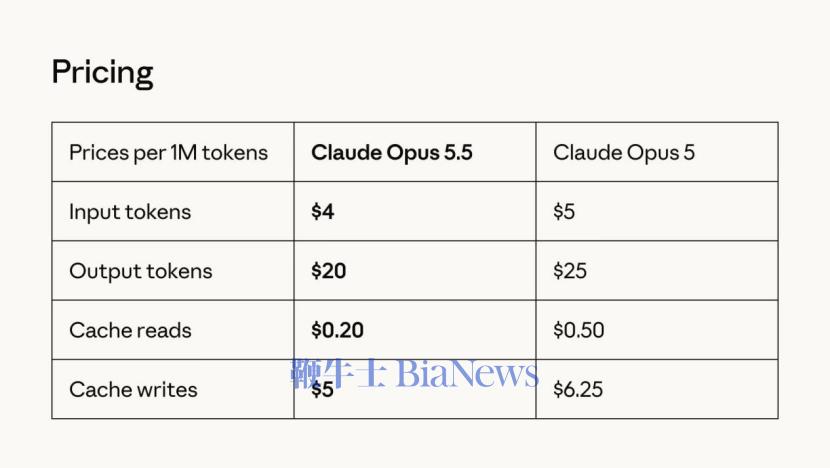
Anthropic这次也调整了定价策略。Claude Opus 5.5在多数任务上达到Fable 5.1的水平,但运行成本比Opus 5低40%。API价格从每百万输入5美元、输出25美元降到了4美元和20美元,降幅20%;缓存读取价格从0.50美元降至0.20美元,降幅60%。输出生成速度比前代提升超过30%。
降得最狠的是OpenAI。
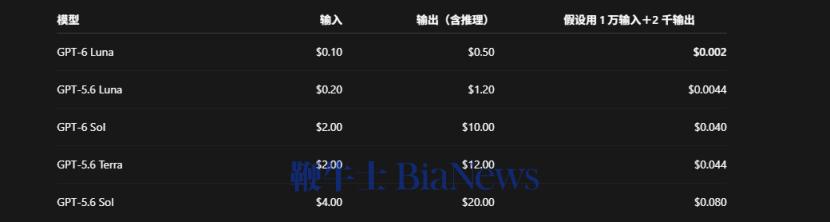
GPT-6 Sol的输入价格从每百万词元4美元砍到2美元,输出从20美元砍到10美元。Luna的降幅同样惊人,输入从0.2美元降至0.1美元,输出从1.2美元降至0.5美元。两款模型的API价格相比GPT-5.6促销价降低了50%。OpenAI CEO Sam Altman在发布后强调,真正重要的指标是完成一项任务要花多少钱,而不是每百万词元的价格。
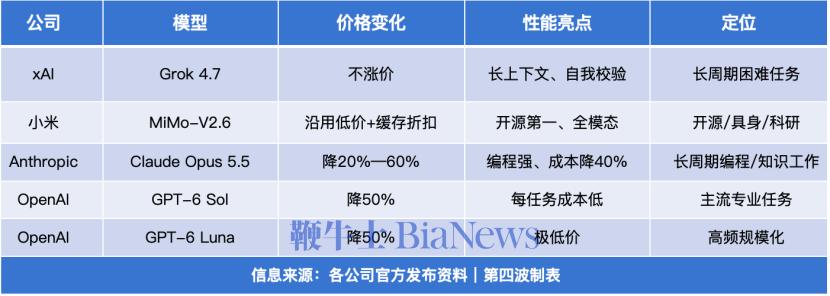
总结看下来,五款模型,默契的没有一家选择涨价,甚至还打起了价格战。
值得注意的是,通用模型的价格战战火已经烧到了语音模型等垂直模型,甚至降价幅度比通用模型还狠。
9月23日,阿里千问正式发布Qwen-Audio-3.1系列语音大模型,五款全新语音模型覆盖“理解-生成-交互-创作”完整栈,且全线价格大跳水:TTS降价约70%,Realtime降幅约85%,ASR降幅更是高达95%。
这五款文本模型加上千问的语音矩阵,价格战已经不是某几家公司的促销行为,是全行业性的趋势。而在这种极致的性价比追逐中,开源阵营所扮演的角色变得尤为特殊。
这五个模型里,MiMo-V2.6是唯一的开源模型,它的位置值得单独拿出来说。
MiMo-V2.6-Pro采用稀疏混合专家架构,总参数1.02万亿,每个词元只激活约420亿参数。它首次支持文本、图片、视频、音频全模态输入,上下文窗口100万词元。
更值得注意的是它的训练效率。Pro版本训练成本约262万美元,Flash版本约85万美元,两个版本合计超过347万美元。在DeepSWE v1.1软件工程基准上,Pro版本从48.8提升到65.7,Flash从58.4提升到72.6。
小米还开源了训练代码和7000多个任务环境,甚至把RL训练的最佳实践也放了出来。这种做法在闭源厂商那里几乎不可想象。
开源模型追赶闭源模型的周期正在缩短。黄仁勋在2026年初判断,开源大模型与顶尖闭源模型的差距约为6个月。到2026年9月,Mozilla基金会的报告显示,这一差距已经缩小到约4个月,而同等能力的开源模型价格仅为前沿闭源模型的五分之一。
五款模型不约而同地选择了场景聚焦,而非追求全能力覆盖。
Grok 4.7和Claude Opus 5.5都瞄准长周期编程和知识工作。
Grok 4.7搭载了比前代更大的基础模型,训练素材侧重耗时较长的复杂实务任务,重点优化长上下文管理和输出结果自我校验。在Artificial Analysis的GDPval-AA v2.1评测中,Grok 4.7得分1695,高于Grok 4.6的1605。作为参照,Fable 5.1 Max 在GDPval-AA v2上为1735。需要说明的是,两者并非同一基准版本,跨版本分数不宜直接横比,但Grok 4.7在同代对比中的提升是明确的。
Claude Opus 5.5在编程测试上更猛。根据Artificial Analysis的独立评测,它在 Terminal-Bench 4.0上得分59.6%,与GPT-6 Astra持平,比Opus 5高出11个百分点。Anthropic官方公布的分数则为66.4%,高于Astra的57.9%,差异主要来自测试环境和推理强度设置。Anthropic公布的一个案例是:一位早期测试者用 Opus 5.5在不到一天内完成了68万行代码的迁移。另一个测试中,审计并修复 20 万行代码库,Opus 5.5用了不到3小时,而Opus 5 需要20多个小时,消耗的词元量也是前者的2.5倍。
OpenAI则选择用产品矩阵覆盖全场景。Astra继续负责最高能力上限,Sol面向需要较强推理和编程能力的主流专业任务,Luna用极低价格承接高频、规模化工作。GPT-6 Sol在AutomationBench测试中以xhigh推理强度取得33.2%的成绩,高于上一代Claude Opus 5在最大推理强度下的26.9%,但单项任务成本为0.27美元,只有Opus 5约3美元每任务成本的9%。OpenAI官方将Astra定位为“当需要最佳结果和不妥协体验时”的选择,Sol则是“能力强、成本可控”的主力,Luna负责极低成本的高频调用。
MiMo-V2.6的场景定位又不一样。依托全模态理解能力,它把触角伸向了3D世界构建、Blender建模、具身智能等方向。在具身仿真环境中,MiMo-V2.6可直接以多视角相机画面为输入,通过视觉反馈闭环控制Franka Panda机械臂,完成物体抓取、颜色匹配与精准放置。更值得说的是它在科研场景中的表现:协助小米前沿材料研究团队开展材料设计与计算筛选,将研发周期从约一个月缩短至2到3天。
这五个模型的发布只是冰山一角。《日经新闻》统计了美国5家公司和包括阿里巴巴、月之暗面在内的中国4家公司更新高性能模型的周期,2023年1月到2026年3月的平均间隔为125天,而2026年4月到9月大幅缩短至44天,仅为以往的三分之一。
Benchmark排行榜上,最强模型的保质期越来越短。从登顶榜首到被超越,现在甚至撑不过一周。
这种速度带来的直接后果是:企业选型逻辑正在从“追最强”变成“挑最合适”。当模型迭代以周为单位,任何一次选型决策的“保鲜期”都在急剧缩短。模型公司显然也意识到了这一点:与其让用户纠结“哪个最强”,不如用产品矩阵覆盖全价格带,让用户按场景选。
Grok 4.7维持原价但性能提升,MiMo-V2.6用开源和低价冲榜,Claude Opus 5.5以更低价格提供接近旗舰的性能,OpenAI用Sol和Luna做场景分层。五个模型,四种策略,但背后是同一个信号:大模型竞争已经从性能天花板,转向了性价比和落地效率。
当然我们依旧要提到,这波降价潮还伴随着一个微妙的背景。Anthropic CEO达里奥在Opus 5.5发布前一周刚刚发表文章,呼吁AI前沿发展“放缓节奏”,主张安全实践应当领先于模型能力。而Opus 5.5正是这一表态后Anthropic发布的首个模型。一边呼吁踩刹车,一边同一天和OpenAI打起价格战,这或许是2026年AI行业最耐人寻味的一幕。
实用主义不是不做最强,而是重新定义“强”:不是榜单第一,而是单位成本下最能解决问题。对企业来说,这个变化意味着:不用再焦虑“哪个模型最强”,而是要想清楚“我的场景需要什么能力、愿意付多少钱”。
当模型变成周抛品,厂商卖的就不再是“智能上限”,而是“落地效率”。
(转载自第四波)
 扫码下载app 最新资讯实时掌握