×
加载中...
提速5倍,智谱把Flash的短板补上了
AI普瑞斯 2026-09-18 14:30
昨天,智谱创始人唐杰刚发文说实现了RSI的最小循环。只用两周,GLM-5.3-Flash优化了服务于自身的推理基础设施,效果直接提高了3倍。

今天,智谱就端出来一个高速版5.3系列模型,推理速度直接飙到200 tokens/s。
图片
新模型名叫GLM-5.3-FlashX,加了个“X”后缀,可以理解为高速版
要知道GLM-5.3-Flash平时也就大概30-50tokens/s,社区里不少用户吐槽他太慢了。
这次升级直接相当于提速5、6倍,这几乎快追上DeepSeek了。
模型速度快,真的很让人舒服。一旦你体验过这种推理速度,几乎是回不去了。这也是很多人喜欢DeepSeek的一大原因。
这次升级算是补上GLM-5.3-Flash推理速度上的短板,算是个重大升级。
毕竟Flash模型的精髓就是快,效率是用户的核心诉求。
目前,GLM-5.3-FlashX API现已上线。
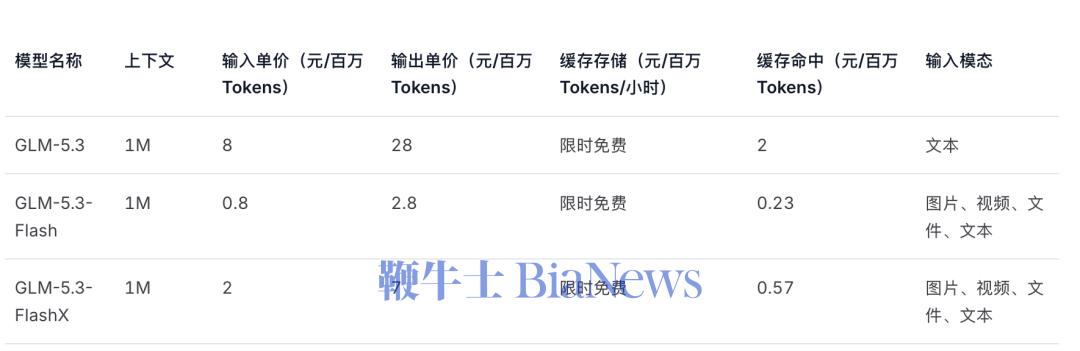
不过速度提升了,价格也涨了。不过仍在可接受的范围。
相比Flash普通版,X高速版输出、输入、缓存命中均涨至2.5倍。但相比GLM-5.3的价格仍低不少。
图片
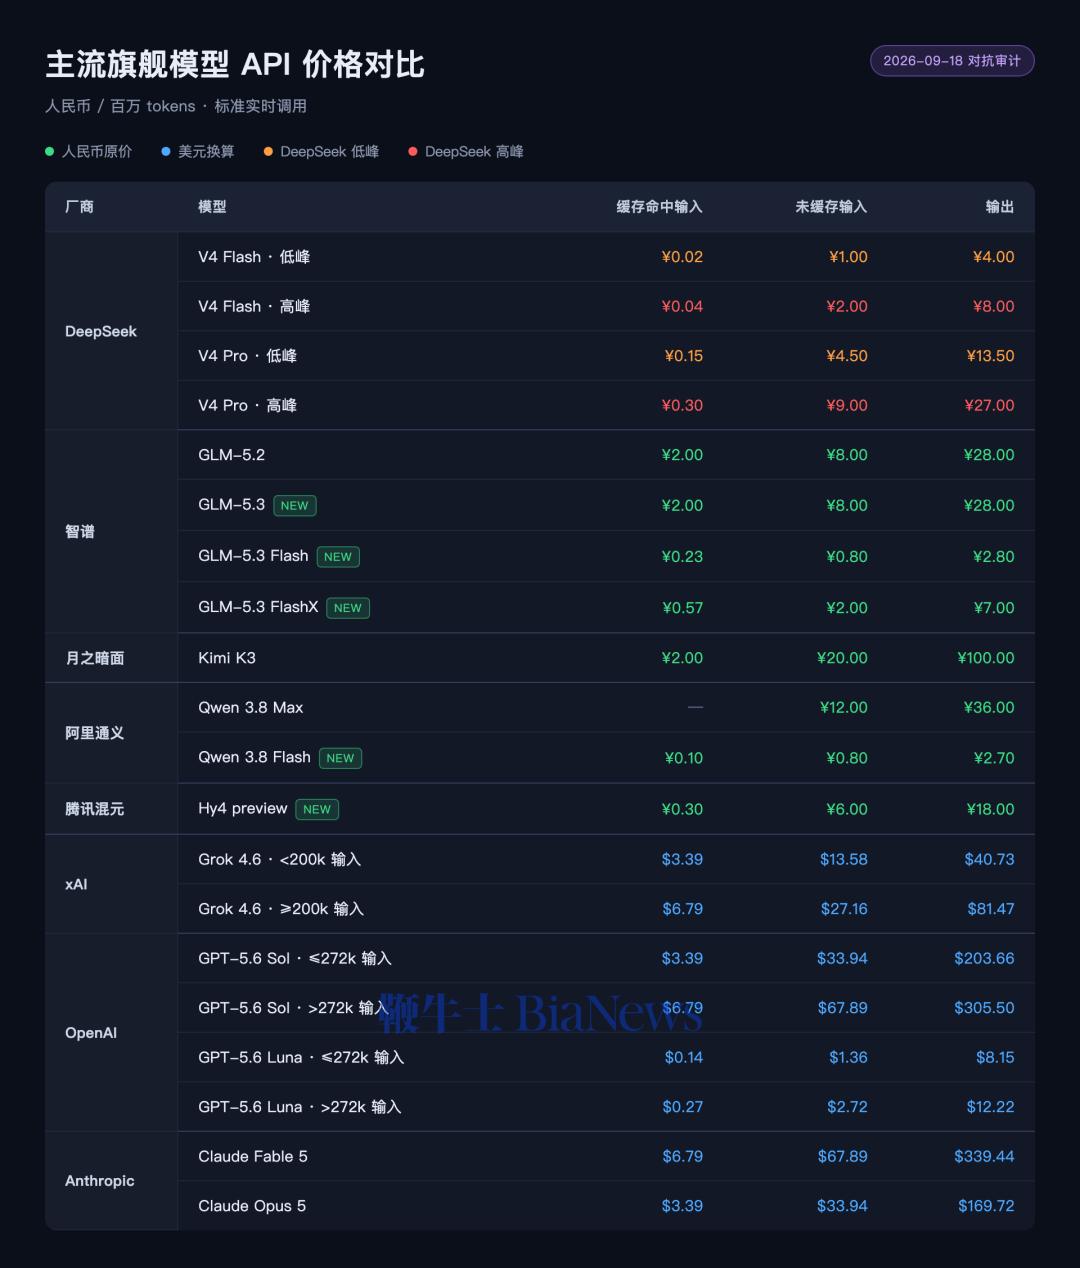
放在整体模型价格图中,X高速版其实和DeepSeek Flash模型的高峰期价格相当,缓存还是DeepSeek低。整体性价比还是靠前的那一档。
price-table.png
如果官方说的200 tokens/s真的不打折,你又想追求速度和性价比,我觉得GLM-5.3-FlashX值得尝试。

(转载自AI普瑞斯)

扫码下载app 最新资讯实时掌握