从Cursor到Genspark,AI应用企业为什么开始训练自己的模型?
Z Finance
2026-09-14 11:30
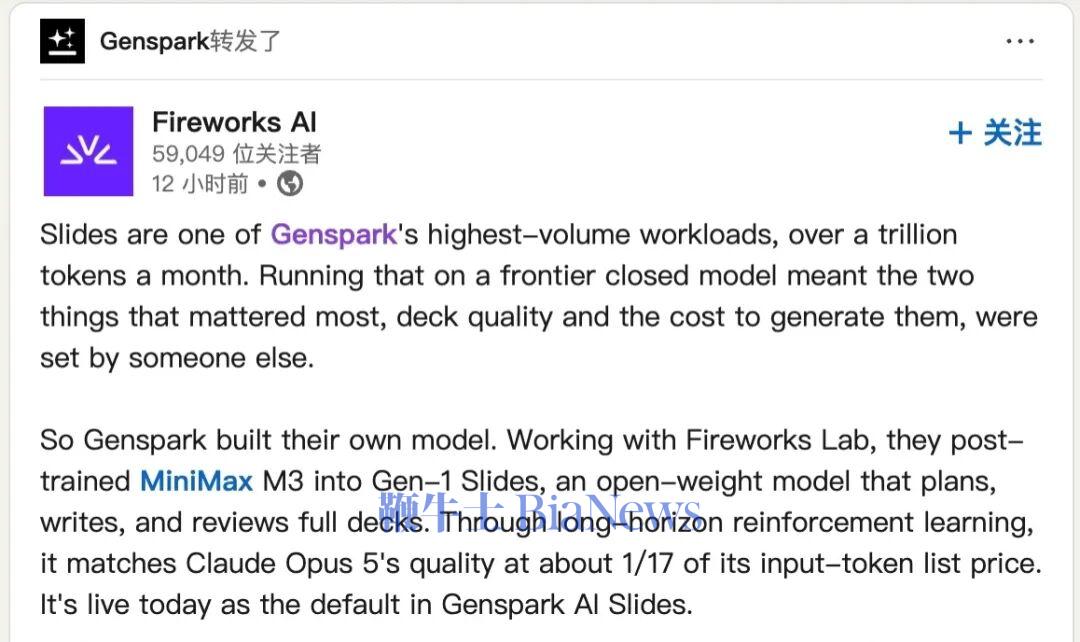
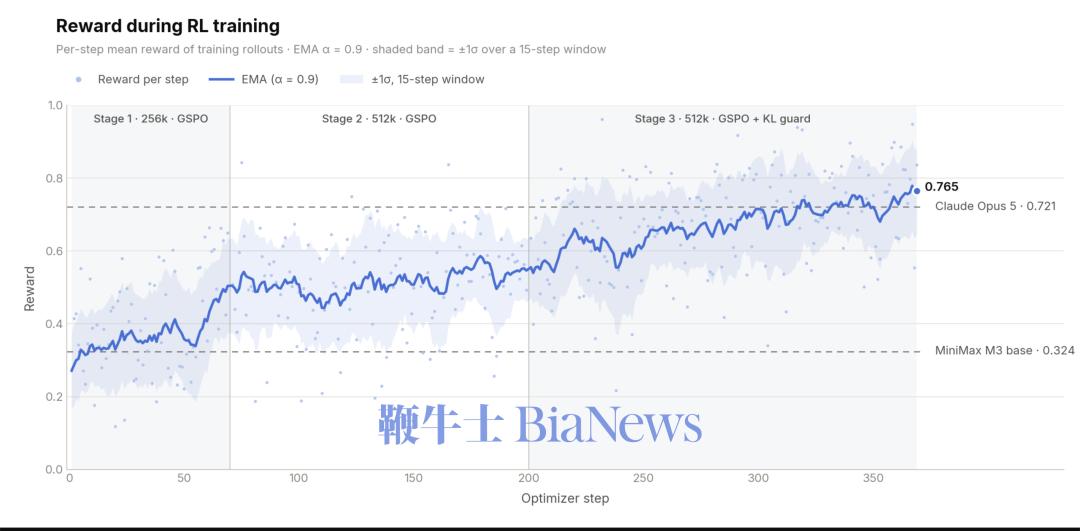
过去两年,AI 应用赛道有一条心照不宣的分工。大厂烧钱做预训练,把模型的能力上限不断推高,应用公司则调 API,叠加 Prompt、RAG 和工具链,把通用智能包装成具体产品。各干各的,边界清楚。 只是这门生意的账,正变得越来越难算。应用公司一边要烧钱获客,一边还要为每一次模型调用付费,用户用得越多,交给模型公司的钱就越多,忙活一场,像是在给模型公司打工。大家开始寻找新的出路, Genspark 给出了一份参考答案。 Genspark 用户有大量做 PPT 的需求,平台一天最多要生成 12 万份。用户大规模生成 PPT 时,既要保证成品质量,也要控制每次生成、检查和修改带来的调用费用。 这周,Genspark 给出了自己的解法 —— Gen-1 Slides,基于开源的 MiniMax M3 联合 Fireworks 做后训练。结果是,综合质量逼近 Claude Opus 5,单份 PPT 的模型成本却从约 4.16 美元降到 0.44 美元,砍掉了近九成。 这背后的信号比 Genspark 产品本身更大。头部应用公司在选择模型之外,现在又多了一项工作:判断哪些任务需要自己训练,在维持交付质量的同时降低服务成本;用户增长之外,还得算算能否留下收益。
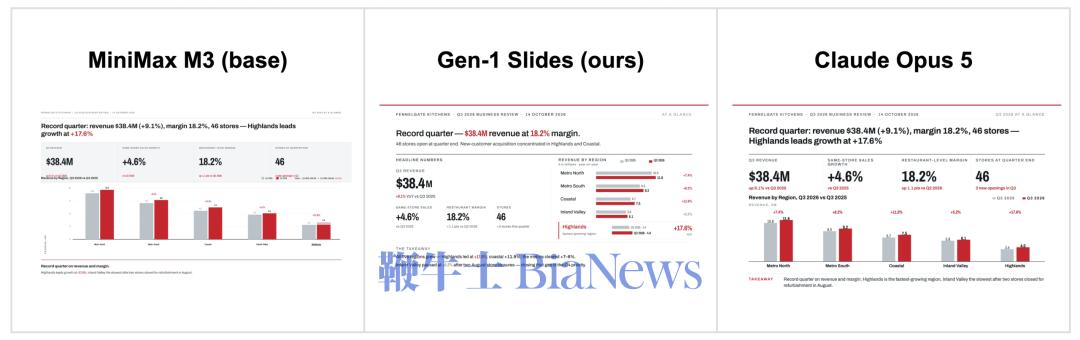
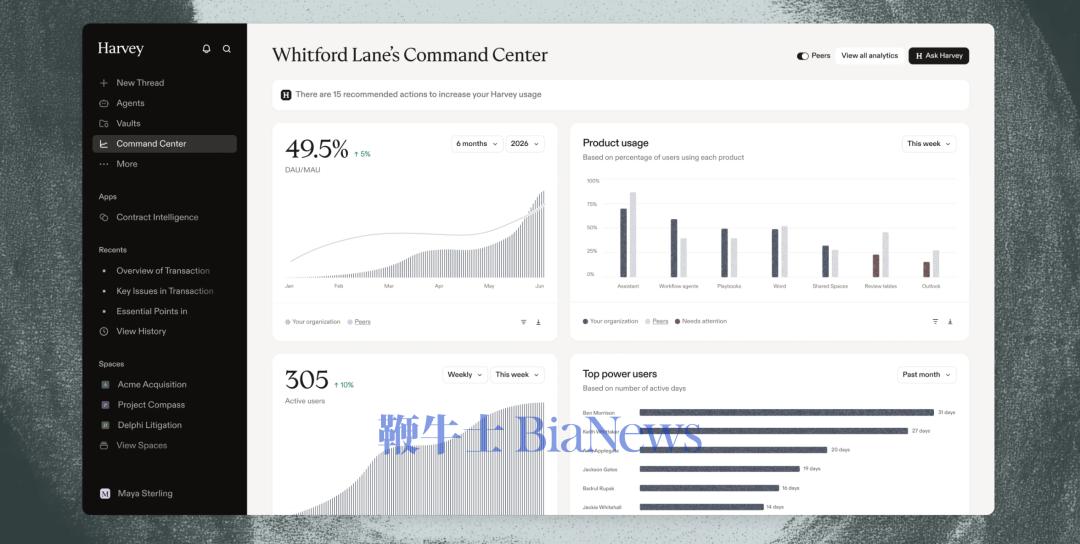
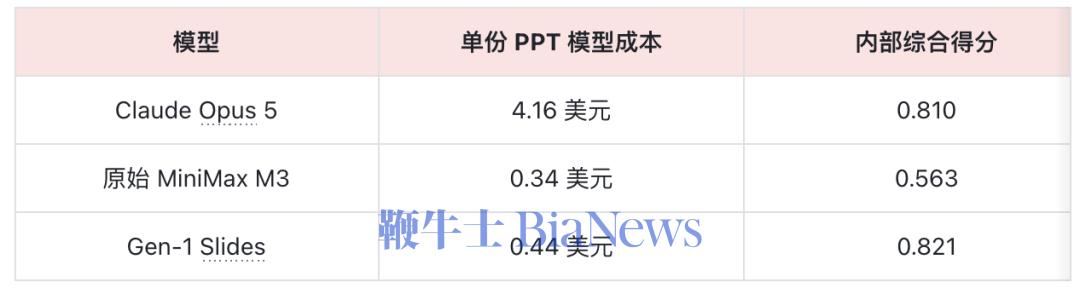
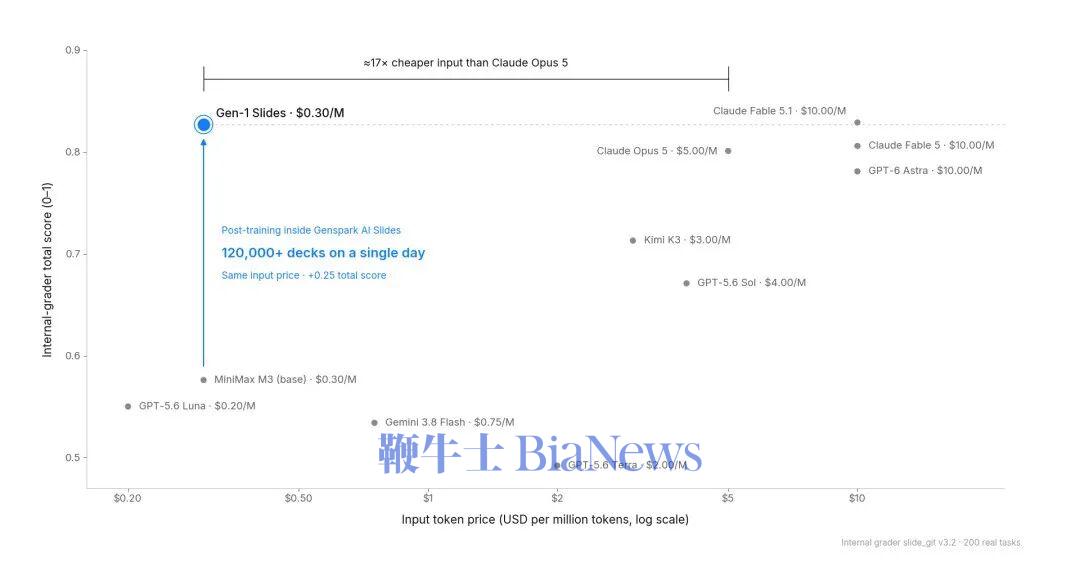
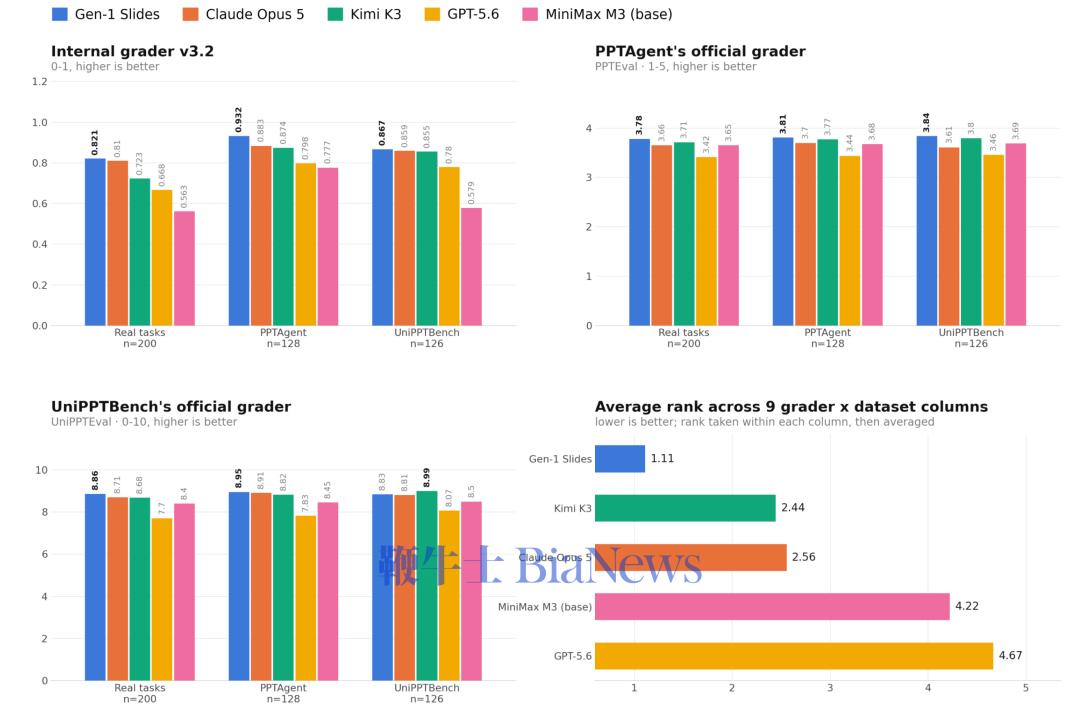
当模型调用成为一笔持续支出 做一份商业 PPT,看上去是图文排版,实际上是一整套交付工程。基座模型在榜单上近乎全能,但应用团队还需要衡量它完成实际任务的质量、速度和费用情况。在保证体验的同时控制调用成本,开始成为产品规模扩大后绕不开的问题。 一份 PPT 从想法到成品,要经过搜集资料、列大纲、写内容、排版、生成图表、检查修改一连串步骤,每一步都是一次模型调用,调用轮次越多,费用就越高。通用模型单步表现不差,但难免会有疏漏和犯错。一旦中间某个环节出错,后面几十轮调用就会沿着错误的轨迹越走越远,需要修改的轮次也变得越来越多。 通用模型需要处理各种任务,应用团队则要对某一类任务的交付结果负责,两者关注的重点有所不同。用户也不关心模型懂多少宏大命题,他们只要在可控的成本里,让模型交出一份拿得出手、不用从头重改的成品。Genspark 的横向对比显示,顶尖通用模型的论述深度几乎挑不出毛病,但视觉和交互得分不算拔尖,成品仍需要经历多轮检查和修改。 门槛更高的法律行业也一样。全球估值最高的美国法律 AI 公司 Harvey 做 过一个实验,让默认配置的 Agent 审查一间虚拟资料室,而模型的大量调用费用花在了无效尝试上。 有意思的是,Harvey 没有换模型,在重新设计了任务拆解和编排方式后,同一模型的合格率立刻蹿升,综合成本反而降了。 这个实验说明,工具如何使用、材料如何组织,都会影响模型的表现。应用团队可以先从工作流入手,解决反复出现的问题。如果这些问题能够被清楚地描述和评价,还可以进一步尝试后训练,让模型更稳定地完成相应任务。 对于大规模的应用企业,这个成本账就值得好好算。Agent 的多轮试错极其烧 Token,顶流模型的多轮调用会增加单次任务成本,影响产品的定价和利润空间,账单很容易击穿毛利。如果为了省钱砍掉一部分自检轮次,模型的真实水平又发挥不出来。应用企业迫切需要找到一种办法,在可接受的成本下稳定完成任务。 基于 MiniMax M3,Genspark 算清了一笔账 直接换便宜模型并不等于省钱,失败率和返工率一上去,省下的 Token 费很快会被吃回去。Genspark 换了个思路,拿开放权重的 MiniMax M3 做垂直后训练,保留较低的调用成本,同时提高PPT质量。 具体怎么练?Genspark 把自己做 PPT 的完整工作流拆成约 2,000 个贴近真实业务的构建任务,让模型在里面反复操练。每一轮产出,内部评分器都会从内容、视觉到任务完成度逐项打分,分数直接作为强化学习的奖励信号。训练目标里专门写进了“检查”和“修改”,模型交稿前必须自己预览、挑错、返工,而不是一次性生成完就撒手。评分器的意见还会回流做自蒸馏,评分规则也持续修补,防止模型练着练着学会钻奖励的空子。 效果可以拿数据说话。在相同的 200 个真实任务、同一套工具和工作流下,三个模型的账很清楚。 M3的原生多模态能力、百万级长上下文和工具调用稳定性,覆盖了月访问量破2000万的Genspark对PPT生成的核心需求。M3的MoE架构和参数设计,对后训练所需的计算和部署资源更低,有利于提高后训练迭代效率,这也是Genspark在MiniMax、 GLM 和Kimi等一众开源模型中,最终选择M3的一项重要原因。和原始 M3 比,Gen-1 每份只多花约 0.10 美元就补上了基础底座与顶级模型之间的质量差。和 Opus 5 比,每份少花 3.72 美元,同样的预算能做出约 9.6 倍的 PPT,质量还在同一档。 拆开看,提升最大的是视觉设计,任务完成度和内容深度仍略逊于 Opus,专用训练重塑了模型的能力结构,并没有让它全面反超。真实用户的反馈更直接,合计 157 万次线上任务里,原始 M3 的低分比例是 18.0%,Gen-1 降到 3.6%,与 Opus 的 3.4% 基本持平,平均评分也从 3.80 星追到了 4.25 星。 完成这轮训练也需要投入算力。单是最后一轮强化学习,就动用了 96 张 NVIDIA B300,跑了大约一周,相当于 1.6 万多个 GPU 小时,这还没算前期试错、任务构建和人工评估的投入。 有两点要说清。其一,降九成只是模型推理费,工具调用、渲染、存储的账另算,真正该比的是交付一份合格 PPT 的总成本。其二,后训练不是一锤子买卖,任务量足够大、质量足够稳,节省才会兑现。但对 Genspark 这样日产 12 万份 PPT 的平台,答案并不难算。开放权重让它跳过了预训练的天价门槛,把资源全部压在自己最熟悉的任务上,而真实任务和用户反馈,正在变成别人拿不走的模型资产。 从 Cursor 到 Harvey,一条共识正在形成 Genspark 并不是孤例。往前看,代码和法律这两个最“重”的垂直行业里,早有人走上了同一条路,这些公司也同样开始利用产品中积累的任务经验,训练更适合自身业务的模型。 比如,Cursor面对的问题是让生成的代码适应已有项目。对模型提出的要求是,需要理解原来的架构,也要判断修改是否符合开发者的要求。程序员的指令往往只有一两句话,模型得自己摸清几十万行的存量架构。仅靠公开代码语料,很难充分覆盖这些判断。 所以 Cursor 干脆自己下场,专有引擎 Composer 2 先在 Kimi K2.5 的开放底座上吃透工程代码,再进沙盒做强化学习,甚至把模型推进真实用户流量,拿开发者的采纳和撤销当奖励信号,最快 5 小时就能滚动训练一轮。产品每天的真实使用,都在给模型上新的课。 Harvey需要解决的是如何评价法律工作。答案是否准确、风险是否遗漏、引用能否支持结论,都需要专业判断。团队将这些要求拆成可供训练和评测使用的指标。 它的自研模型 Tenet 用公开判例、合成数据和合伙人标注做后训练,全程不碰客户底稿,等于造了一座高保真的“模拟考场”,专门教模型什么叫专业。在更细的报表审查场景,Harvey 基于 GLM-5.2 定制的模型,解析成本比 Claude Sonnet 5 降低五成。 应用层真正的壁垒,是摸透这门生意里最琐碎的交付关卡,并带来足够的成本节省。两个案例的共同之处,是团队先明确任务要求,再据此组织训练。业务经验由此进入了模型开发过程,而不只体现在提示词和产品设计中。 应用公司的护城河 在哪里? 红杉合伙人 Sonya Huang 有句话在业内流传很广:“Not your weights, not your product”,翻译过来就是,不握有权重,就谈不上真正拥有产品。但这不是劝大家和闭源巨头硬脱钩,而是学会根据成本、响应速度和业务要求,决定哪些任务继续调用外部模型,哪些值得自己训练。Harvey、Glean 这些先行者,本质上都在向新型应用研究实验室蜕变。 光有权重也挡不住对手。开源底座人人能下,微调出来的些许领先,转头就会被通用模型的下一次版本更新抹平。真正难复制的,是一套持续自进化的工程飞轮。应用企业需要持续从用户的反馈中识别问题,通过评测判断改动是否有效,并让训练跟上产品变化。这些工作都需要持续进行。 AI 应用的竞争,第一阶段拼谁先接上模型,第二阶段拼谁先理顺工作流。对应用公司来说,调用通用模型和训练专用模型可以同时进行。前者让产品持续获得新的模型能力,后者则为高频任务提供了控制成本的机会。而在应用公司拼差异化的同时,开源模型也在拼一件事:怎样能成为更多公司的底层模型。这一轮竞争里,MiniMax 先抢得一分。如何在性能、部署成本和可定制空间之间找一个更平衡的位置,让“用得起”和“用得好”之间不再二选一,将是开源模型的新赛点。
(转载自Z Finance)
扫码下载app 最新资讯实时掌握
 扫码下载app 最新资讯实时掌握